「谁该得到署名?」:AI 时代的归属争议,与一个更该追问的判断标准
整理 Nature 新闻《Who gets credit in the AI era?》并作分析:OpenAI 宣称用 AI 模型解决纳维–斯托克斯问题后,争议从「AI 能不能做」转向「功劳算谁的」——两位数学家的质疑与 OpenAI 的回应、25 位菲尔兹奖得主的公开信、以及一个更典型的群论案例。文末是本站观点:判断学术价值,该看的不是「是不是 AI 写的」,而是它解决了什么、证据是否站得住、过程是否可核验。
整理说明:本文整理自 Nature 新闻《Who gets credit in the AI era? OpenAI maths bombshell sparks debate》(2026-09-17,作者 Davide Castelvecchi),引文保留原文表述(中译为本站所加)。文首配图为原文配图(Credit: Hill Street Studios/Getty);两张示意图为本站自制。文末「本站观点」一节,是站长提出的判断,并在此基础上作了展开。
引子:争议的第二幕
OpenAI 于 9 月 8 日宣布,它用一个人工智能模型解决了流体力学中的一大难题——纳维–斯托克斯问题。Nature 的这篇报道说,这很可能永远改变数学的研究方式;但它同时点燃了另一场争议:OpenAI 的工具,是否从那些同样在用 AI 攻克这个问题的人类数学家那里学到了东西?
注意这里的重心已经不是「AI 能不能做数学」,而是**「功劳算谁的」**。
一、为什么这件事会波及整个学术界的「署名」概念
报道给出的判断是:AI 模型在绝大多数研究领域被广泛使用,而训练数据的来源极难追溯,这可能让「学术署名」这一概念本身陷入困境。
伦敦政治经济学院研究知识产权法的 Luke McDonagh 说:
「学术研究者很可能还没有完全意识到,把数据与知识上传到个人 AI 模型账号意味着什么。」
而在一封批评 AI 公司介入数学问题求解的公开信中,25 位菲尔兹奖得主写道,AI 工具让适当署名变得模糊:
「与所有创造性职业一样,这带来了严重的署名与抄袭问题。」
二、两方说法:一位数学家的质疑与公司的回应
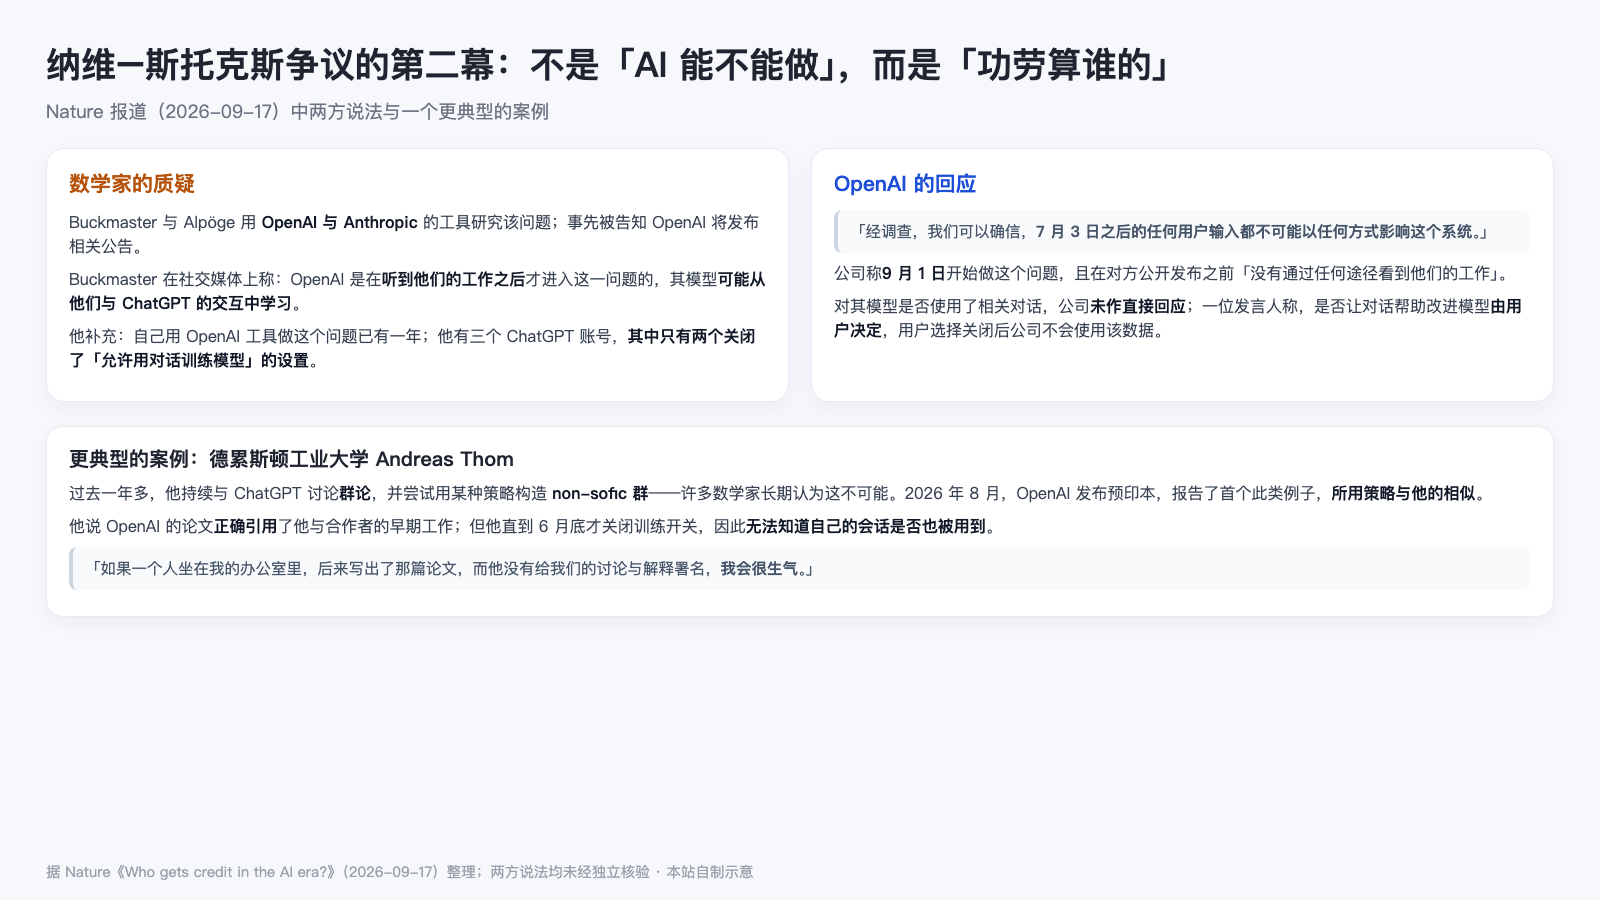
纽约大学的 Tristan Buckmaster 与哈佛大学的 Levent Alpöge 一直在用 OpenAI 与 Anthropic 的工具研究该问题的一个方面。在 OpenAI 正式确认之前,他们已被告知公司准备宣布解决了这个问题。Buckmaster 在社交媒体上写道:公司是在听到他与 Alpöge 的工作之后才扑向这个问题的,而 OpenAI 的模型可能从他们与 ChatGPT 的交互中学习。
OpenAI 方面对 Nature 的回应是:
「经调查,我们可以确信,7 月 3 日之后的任何用户输入都不可能以任何方式影响这个系统。」
公司称自己在 9 月 1 日开始处理这个问题,并且在两人公开发布之前「没有通过任何途径看到他们的工作」。Buckmaster 则说,他用 OpenAI 工具研究该问题已有一年;他有三个 ChatGPT 账号,其中只有两个关闭了「允许用对话训练模型」的设置。
⚠️ 两方说法均未经独立核验。这条提醒很重要:报道呈现的是争议结构,而不是已经查清的结论。
三、一个更典型的案例:群论里的一次「办公室谈话」
德累斯顿工业大学的数学家 Andreas Thom 提供了更贴近日常研究的例子。过去一年多,他持续与 ChatGPT 讨论群论,并尝试用某种策略构造 non-sofic 群——许多数学家长期认为这不可能。2026 年 8 月,OpenAI 发布预印本,报告了首个此类例子,所用策略与他的相似。
Thom 说,OpenAI 的论文正确引用了他与合作者的早期工作;但他直到 6 月底才关闭训练开关,因此无法知道自己的会话是否也被用于训练。他的类比很朴素:
「如果一个人坐在我的办公室里,后来写出了那篇论文,而他没有给我们的讨论与解释署名,我会很生气。」
(报道说明:目前并未确认 OpenAI 的模型确实使用了 Thom 的对话。)OpenAI 未就此直接回应,但一位发言人称,是否让对话帮助改进模型由用户自己决定;用户选择关闭后,公司不会用这些数据改进模型。
四、奖金与验证:一个程序问题
假设 OpenAI 的解法被独立确认,接下来的问题是:数学界如何分配功劳,以及谁能拿到克雷数学研究所为千禧年难题设立的 100 万美元奖金。
- OpenAI 表示,它已用 Lean 这种编程语言验证了自己的证明;
- 克雷数学研究所(科学总部在牛津)表示,只有当结果在同行评议的出版物上发表、并经学界进一步检验之后,它才会考虑该解法是否成立;
- 报道提到,研究纳维–斯托克斯方程的研究者认为,很大一部分功劳应当归于 Buckmaster 与 Alpöge,以及马德里数学科学研究所的 Diego Córdoba 与 CUNEF 大学的 Luis Martínez Zoroa。
五、本站观点:判断标准该换一换了
以上是文章的整理。下面这一段是站长提出的判断,我把它展开一下。
核心主张:研究也好、论文也罢,不必再以「是不是 AI 写的」来判断它有没有价值。只要真正能解决现实问题、造福人类,无论 AI 写还是人写,都有价值。学术领域的评价方式——尤其是学术论文的写作与评审——该改进这一点:不要纠结是否由 AI 写成,因为所谓「AI 写的」背后,人同样在参与:提出问题、给出方向、引导 AI 做研究与分析、判断取舍,最后形成论文。
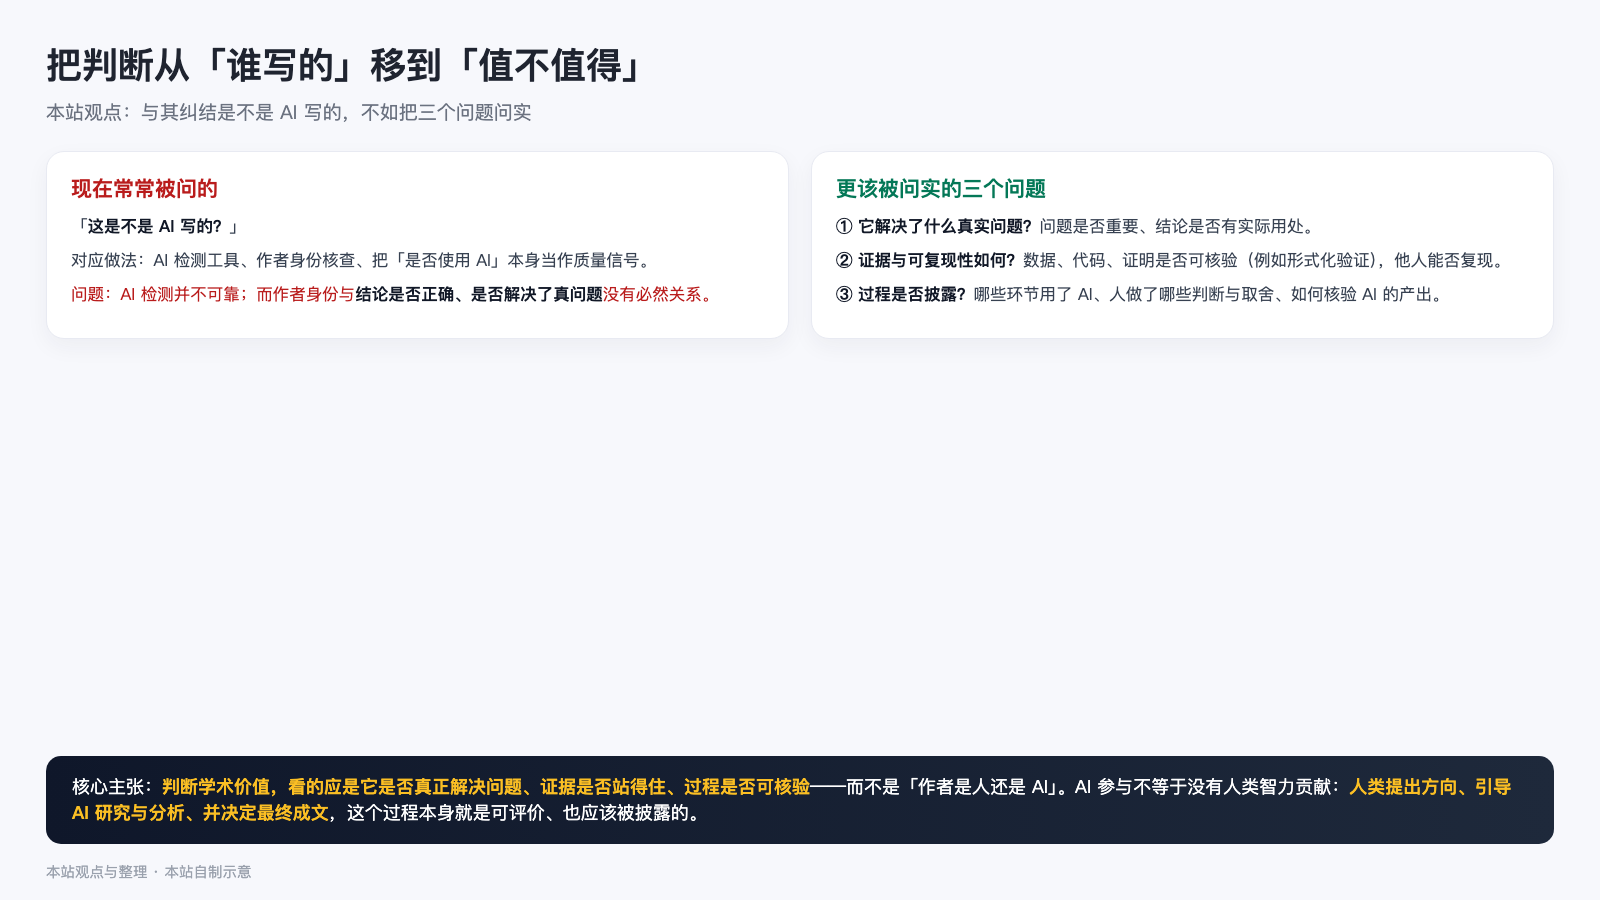
我认为可以落成三条可操作的口径:
- 评价对象换一栏:从「作者身份」转向「主张 + 证据 + 可复现性 + 实际效用」。一篇论文值不值得读,取决于它解决了什么问题、结论站不站得住,而不是它的字句由谁敲出来。
- 过程必须披露:哪些环节用了 AI、人做了哪些判断与取舍、AI 的产出如何被核验。这恰恰是上面那篇 Nature 报道的核心痛点——归属之所以说不清,正是因为过程与数据流向不透明。
- 用可核验的产物替代「AI 痕迹检测」:数据与代码、可执行的形式化证明(如报道中提到的 Lean)、以及必要时可提交的交互记录。能被复现与检验的东西,比任何「AI 检测分数」都更接近学术判断的本意。
**这三条同时解决两件事。**文章问的是「功劳算谁的」;而如果过程不披露、产物不可核验,归属永远说不清。反过来,把过程与产物做实,归属有了依据,评价也有了依据——两个问题其实是一枚硬币的两面。
但「不纠结是不是 AI 写的」不等于「不必说明」。 有几点边界必须保留,否则这条主张会被误用:
- 披露仍是义务:不判断「谁写的」,不等于可以不说明「怎么做的」。Nature 在同一时期还有一篇社论,标题就是《AI 公司必须与研究界合作保护归属》——方向一致。
- 责任主体必须是人:谁提交、谁署名,谁就要对内容负责。AI 不能署名,也承担不了责任。
- 要区分两类场景:研究成果是否有价值,与学生是否掌握了写作与研究能力,是两个问题。前者看主张与证据;后者的教学目标里,「自己动手写」本身就是目的——把这两件事混为一谈,这条主张就会误伤教学。
结语
归属争议不会因为技术改进而自动消失。但把评价标准从「谁写的」移到「值不值得」,至少能让讨论回到可以用证据回答的地方:它解决了什么真实问题,证据在哪里,过程能不能被复现。
这比花力气鉴定「这段文字像不像 AI 写的」,要有用得多。
来源:Nature · Who gets credit in the AI era? OpenAI maths bombshell sparks debate(News,2026-09-17,Davide Castelvecchi)|相关社论:AI companies must work with the research community to protect attribution(Editorial,2026-09-16)