提示 LLM 的高等教育自动评分与反馈生成:提示组合、任务顺序与成绩公平性
论文精读:AlGhamdi 等(2026)系统对比单提示组合与双提示分解、先反馈后评分与先评分后反馈四种配置,发现 GPT-4o 在「组合提示 + 先反馈后评分」下评分最准(RMSE 差异显著,p=.046),且对高分学生作品评分更准确。
文献:AlGhamdi, E. M., Li, Y., Gašević, D., & Chen, G. (2026). Leveraging prompt-based LLMs for automated scoring and feedback generation in higher education. Computers & Education, 243, 105511.
研究问题:大语言模型(LLM)能否同时承担“自动评分”与“反馈生成”两项任务?以往研究大多把评分与反馈分开考察,且停留在“换更强模型”的思路上,很少追问一个更基础的问题:同一个模型(GPT-4o),提示方式不同,表现会差多少? 具体而言,论文考察两个提示工程维度——单提示组合(prompt composition):用一个提示同时要求模型完成评分与反馈;双提示分解(prompt decomposition):用两个连续的提示分别完成两项任务;以及任务顺序(task order):先评分后反馈,还是先反馈后评分。进一步地,评分误差是否随学生成绩水平而变化,即自动评分对不同水平学生是否公平。
论证思路:作者把提示工程视为影响 LLM 输出质量的“第一杠杆”,将两个二分类变量(组合 vs 分解、先评分 vs 先反馈)交叉为四种提示配置,在同一模型(GPT-4o)、同一数据集、同一评分量表下做受控比较,用平均绝对误差(MAE)、均方根误差(RMSE)与排名一致性指标(RMC)量化评分与人类评分的偏差,并补充统计显著性检验。论文同时按人类评分把学生作文分为不同成绩水平,考察评分误差的分布是否偏向某一水平群体;反馈提示中则嵌入学习者中心原则(learner-centered principles),检验“个性化反馈”能否在不牺牲评分质量的前提下实现。
一、提示工程的两个关键抉择
1. 提示组合(prompt composition)vs 提示分解(prompt decomposition)
提示组合指把“评分”与“反馈”两项任务写进同一条提示,让模型一次调用同时输出分数与反馈。其潜在优势在于:两条任务共享同一上下文,模型在写反馈时“看到”自己的评分推理,输出在语义上更自洽;只调用一次接口,延迟与成本更低。风险在于:一次输出两件事容易互相干扰——模型可能在评分与反馈之间“精神分裂”,或为了凑反馈而扭曲评分,且输出格式更难约束。
提示分解则把任务拆成两个连续的提示:第一个提示只让模型做一件事(比如只评分),第二个提示再让它做另一件事(比如只生成反馈)。其优势是任务单一、认知负荷低、输出格式稳定可控;代价是两次调用带来双倍延迟与成本,且如果第二个提示看不到第一个的输出,两项任务就完全失去共享上下文。论文的问题正是:这种“专注”的代价是否值得?组合的“共享上下文”红利是否真实存在?
2. 任务顺序:先反馈后评分,还是先评分后反馈?
任务顺序的直觉来自思维链(chain-of-thought)式推理:如果让模型先写反馈——先逐条解读学生作文的长处与不足、给出改进建议——它实际上被迫对文本做了一次深度的、结构化的阅读;这份“读懂了的”中间产物再被用于评分,评分或许就建立在更完整的理解之上。 反过来,如果先给分数再写反馈,评分可能只是模型对文本的第一印象,反馈则沦为对分数的“事后辩护”。
因此“先反馈后评分”本质上是一种隐式的推理前置:反馈不是附加输出,而是评分前的推理脚手架。这个假设是全文最值得记住的提示工程洞见,也是“任务顺序影响表现”这一反直觉结果的理论来源。
3. 四种配置与统一基准
两个维度交叉出四种条件:
- Composition-Feedback-First:单提示,先反馈后评分;
- Composition-Scoring-First:单提示,先评分后反馈;
- Decomposition-Feedback-First:双提示,先反馈后评分;
- Decomposition-Scoring-First:双提示,先评分后反馈。
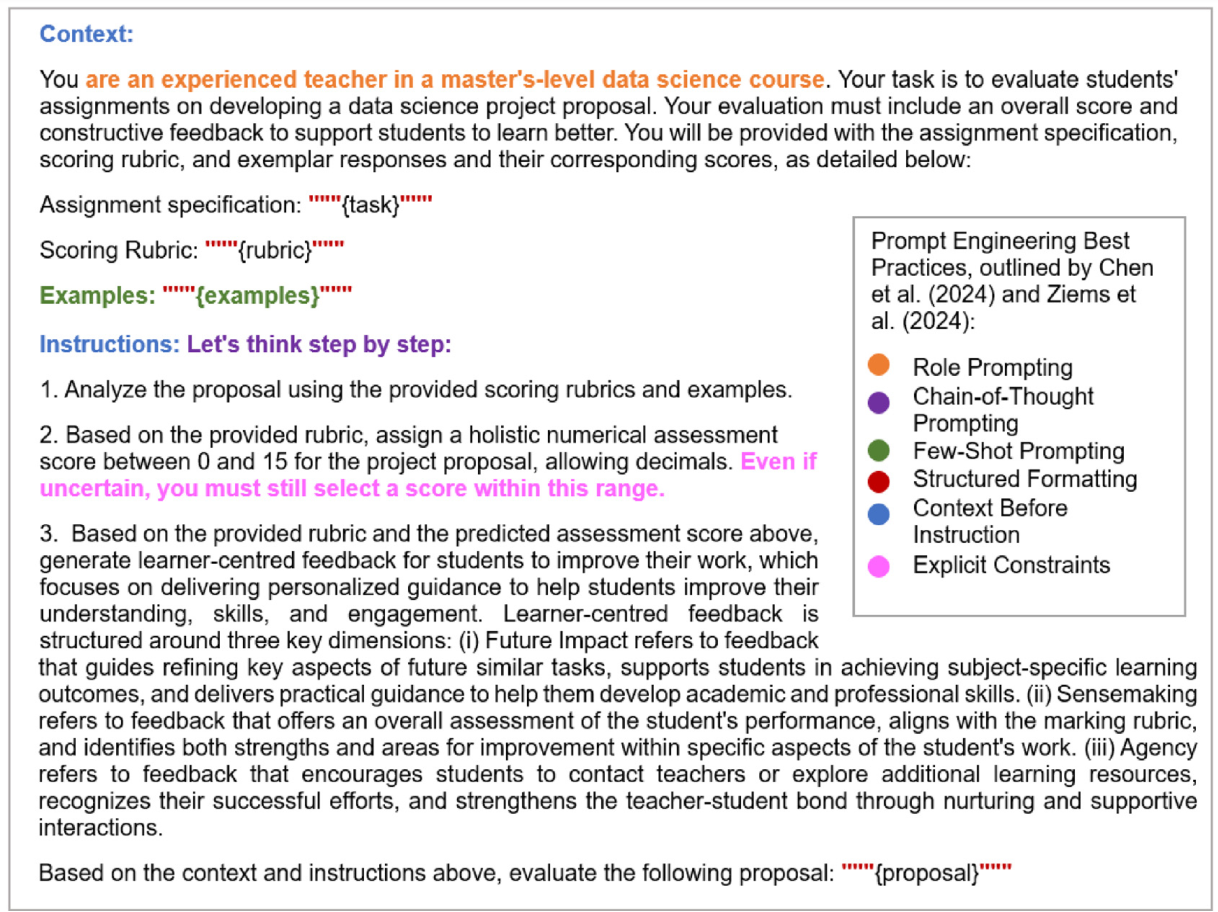
四种配置使用相同的模型(GPT-4o)、相同的作文题提示模板(见原文 Figure 2)与相同的评分量表,仅操纵组合方式与任务顺序,从而把性能差异归因于提示结构本身。
二、结果:组合 + 先反馈后评分全面占优
1. 最优配置:Composition-Feedback-First
在所有配置中,「组合提示 + 先反馈后评分」取得了最佳评分准确度。以次优的 Decomposition-Feedback-First 为基准,Composition-Feedback-First 的 MAE 低 3.1%、RMSE 低 2.2%、RMC 高 7.7%——即在绝对误差、大误差惩罚和排名一致性三个维度上全面领先。其中 RMSE 的差异达到统计显著(p = .046),这是自动评分研究中少见的、对提示配置差异做了显著性检验的证据。
2. 任务顺序的稳定效应:先反馈后评分更准
无论采用组合还是分解,「先反馈后评分」都优于「先评分后反馈」。这说明顺序效应不是某一种提示结构的偶然副产品,而是一个稳健的规律:让模型先产出反馈(相当于先完成一次深度阅读理解),再据此评分,能系统性地降低评分误差。对实践者而言,这条结论几乎是“零成本”的提示修改——不换模型、不加调用,只调整提示内任务的先后顺序,就能获得更准的评分。
3. 成绩水平分组:高分作品评分更准
把作文按人类评分划分为不同成绩水平后发现,LLM 对高分学生作品的评分明显更准确(MAE 低 19%–34%)。一个合理的解释是:高分作文结构清晰、论证连贯、语言规范,恰好落在模型训练语料中“优秀范文”的分布上,模型对“好文章”的判断更有把握;而低分作文往往伴随离题、论证薄弱、语言错误密集等问题,模型对“差”的程度缺乏稳定锚点,评分波动更大。这一发现把论文从“提示工程”引向”评估公平性“:自动评分系统对低分群体可能系统性更不可靠,若直接用于高利害评估(如期末成绩、奖学金评定),需要额外警惕。
三、个性化反馈中的学习者中心原则
论文没有止步于“评分更准”,而是同时回答了“反馈是否对学习者更有用”。反馈提示中嵌入了学习者中心原则:反馈不应只是“对/错”的宣判,而应针对学生作文的具体问题定制——指出具体位置与具体缺陷、解释为什么这是问题、给出可操作的改进建议,并在必要时示范改写。换言之,反馈的目标是让学生知道“下一步该改什么、怎么改”,而非仅仅被告知分数。由于评分与反馈在同一次提示中完成,“先反馈后评分”既提升了评分质量,又保证了反馈建立在同一份深度阅读之上——评分与反馈第一次在同一个推理过程中被统一起来。
四、对高等教育评估实践的启示
这篇论文对大规模评估实践(MOOC、大班课、在线作业)有直接而务实的启示:
- 部署层面:不换模型也能显著改善自动评分——把“先反馈后评分、单提示组合”作为默认提示配置,比盲目追求更强的模型更便宜、更可控;
- 成本层面:组合提示只需一次 API 调用,同时产出评分与反馈,比双提示分解省一半调用开销,且效果更好——“更省”与“更准”在这里不冲突;
- 风险层面:对低分学生的评分偏差意味着自动评分不宜直接用于高利害决策,需要人类复核或校准后处理;
- 反馈层面:学习者中心原则提供了让 LLM 反馈“可行动化”的提示模板,可迁移到其他学科的写作任务。
五、精读笔记
核心论点:LLM 自动评分的质量不只取决于模型,更取决于提示的组织方式——单提示组合优于双提示分解,先反馈后评分优于先评分后反馈;最优配置(Composition-Feedback-First)在 MAE、RMSE、RMC 三个指标上全面领先,RMSE 差异显著(p = .046)。同时,评分准确性随学生成绩水平分化(高分作品 MAE 低 19%–34%),提示工程之外必须关注评估公平性。
方法要点:
- 2×2 因素设计:组合/分解 × 先评分/先反馈,四种配置在同一模型、同一数据、同一量纲下受控比较,归因清晰;
- 指标选择:MAE 与 RMSE 度量误差大小(RMSE 对较大误差更敏感),RMC 度量与人类评分的排名一致性,三者互补;
- 显著性检验:对配置间差异报告 p 值(RMSE,p = .046),把提示工程比较从“描述性”提升到“推断性”;
- 成绩水平分组分析:按人类评分分层考察误差分布,把技术评估与公平性关切接合;
- 学习者中心原则嵌入:反馈提示按“指出问题—解释原因—给出建议—示范改写”组织,实现个性化反馈。
局限与边界:
- 单模型证据:结论基于 GPT-4o,其他 LLM(如 Claude、Llama 等)未必呈现相同的最优配置与顺序效应;
- 单任务类型:实验基于作文题,短答题、代码题、多选题的提示结构效应可能不同;
- 边缘显著:差异主要体现在 RMSE 上(p = .046 属边缘显著),MAE 与 RMC 的差异未达显著,效应量需更多复制;
- 提示敏感性:提示措辞、评分量表、领域语料都可能调节结论,提示工程发现的外推需谨慎;
- 公平性未闭环:论文识别了低分作品评分更不准的现象,但未提出完整的偏差校正方案。
可延伸方向:
- 多模型 × 多任务复制:在多种 LLM 与多种题型(短答、代码、论证写作)上检验“先反馈后评分”的稳健性;
- 通用化验证:把“反馈前置”作为通用提示策略,迁移到翻译评分、代码评审、同行互评等相邻任务;
- 可解释评分:让模型在评分时输出逐条 rubric 对照依据,把评分从黑盒变成可审计;
- 公平性校准:针对低分群体的评分偏差设计后处理或人机混合复核流程;
- 反馈质量的人工评估:评分指标之外,用学习者端的结果(修订质量、学习收益)评估反馈是否真的有用;
- 成本—效益分析:把提示配置差异换算为 API 成本与延迟,为大规模部署提供经济性决策依据。
原文地址
- DOI:10.1016/j.compedu.2025.105511
- 期刊:Computers & Education, 2026, 243, 105511
- 图表来源:原文 Figure 2