贝叶斯网络方法能为教育研究带来什么?
论文精读:顾昕等(2022)提出用贝叶斯网络应对教育数据的复杂、不确定与动态特征。
文献:顾昕、毛梦琪、马淑风、陈森宇《贝叶斯网络方法能为教育研究带来什么?》,《华东师范大学学报(教育科学版)》2022 年第 11 期。
研究问题:教育实证研究数据呈现复杂、不确定、动态三个特征,传统统计方法(方差分析、回归分析)在这类数据上存在哪些局限?是否存在能同时处理这三类特征的分析方法?
论证思路:论文先指出现有方法的三个局限,再引入贝叶斯网络作为应对方案,依次说明其原理、优势、算法与软件,最后以教育实证案例演示完整建模流程。
研究背景:传统方法的三重局限
教育实证研究的对象通常是多维度、多层次的复杂建构。论文指出现有方法在处理此类数据时存在三个具体问题:
- 结论不包含不确定性信息:只能报告“显著差异”“显著影响”,但变量状态的概率分布无法给出
- 模型不可更新:研究设计、样本容量在实验前固定,后续数据无法累积或修正模型
- 对数据类型有较强假设:正态性、线性、方差齐性等要求,类别变量的非线性关系难以处理
方法介绍:贝叶斯网络
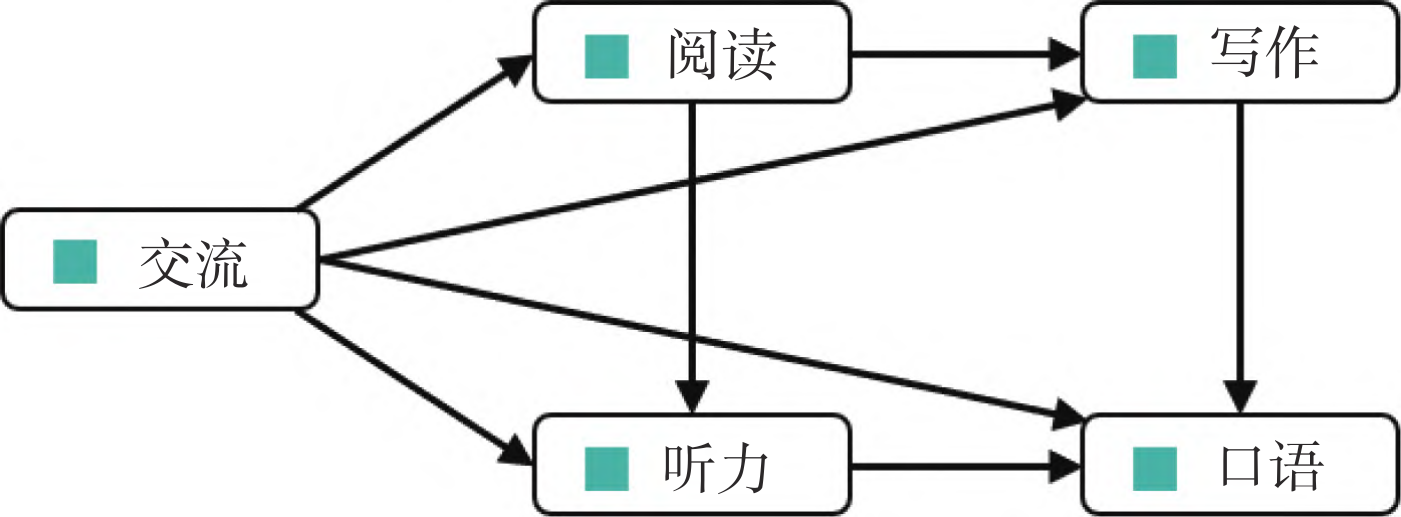
贝叶斯网络是一种概率图模型,用有向无环图表达变量间的依赖关系。节点表示变量,有向边表示依赖。论文以英语能力评估为例说明其表达方式——写作与听力水平依赖于阅读能力,同时又影响口语水平,对任一能力的评估需同时考虑其他能力:
与路径分析、结构方程模型相比,贝叶斯网络的差异体现在三点:
- 不要求变量间线性关系,可处理类别变量的非线性关系
- 以概率形式报告结论,适用于诊断与预测
- 支持随数据更新——数据证据可以累积,也可以被推翻
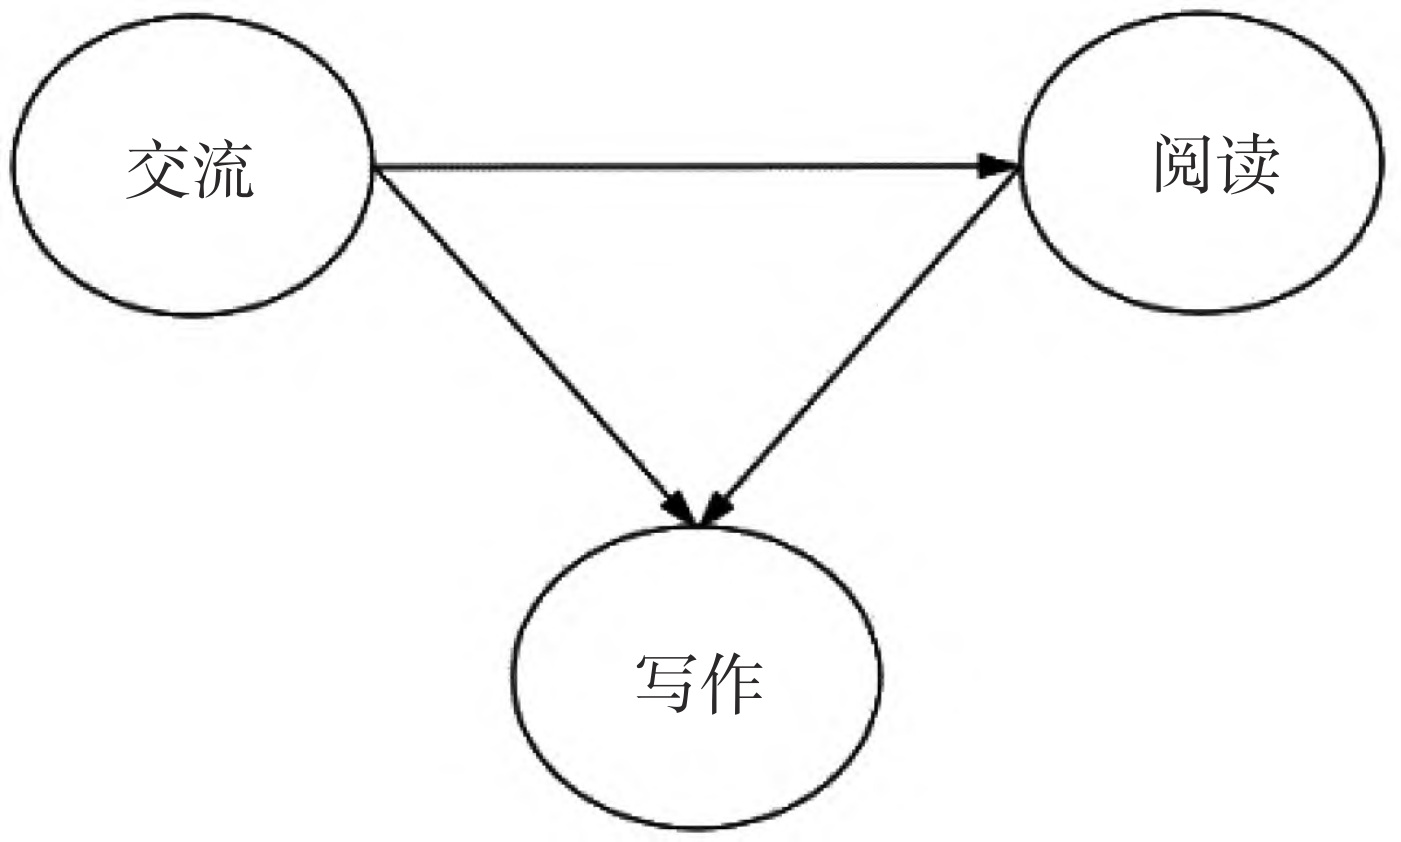
贝叶斯推理的基本过程是根据已知变量状态推断未知变量的概率:
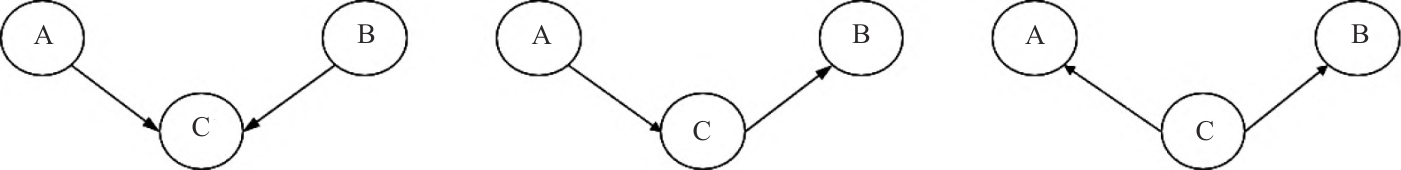
网络中的节点关系由三种基本结构组合而成——链式(A→B→C)、分叉(B 有两个子节点)、对撞(两个父节点指向同一子节点):
论文主张的五个优势
作者将贝叶斯网络对教育实证研究的贡献归纳为五点,以下分别梳理其内容与依据。
1. 理论驱动与数据驱动的融合
专家经验与教育理论进入先验模型,数据随后迭代修正。这一流程避免了纯理论路径“研究设计确定后无法增删变量”的问题,也弥补了纯数据路径“只能判断相关、无法解释机制”的不足。
2. 个体层面的概率推理
论文以网络学习中的信息加工风格为例。论坛行为(回复/阅读/发布/不参与)与聊天行为(参与/聆听/缺席)作为观测变量,信息加工风格(活跃/沉思)为目标变量:
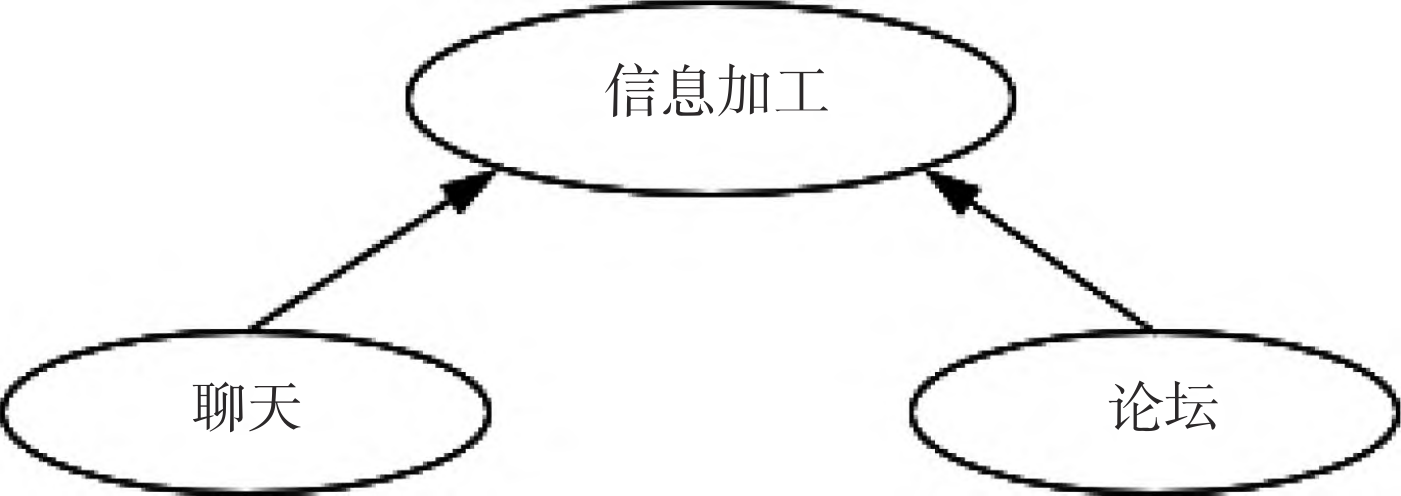
给定观测行为可输出目标变量的条件概率。例如:学生在论坛回复消息且参与聊天,则信息加工风格为活跃型的条件概率为 0.85;另一学生在论坛仅阅读消息且缺席聊天,则为沉思型的条件概率是 0.55。完整条件概率表如下:
| 信息加工 | 论坛:回复消息 | 论坛:阅读消息 | 论坛:发布消息 | 论坛:不参与 | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 聊天:参与 | 聆听 | 缺席 | 参与 | 聆听 | 缺席 | 参与 | 聆听 | 缺席 | 参与 | 聆听 | 缺席 | |
| 活跃 | 0.85 | 0.70 | 0.55 | 0.75 | 0.60 | 0.45 | 1.00 | 0.85 | 0.70 | 0.65 | 0.50 | 0.35 |
| 沉思 | 0.15 | 0.30 | 0.45 | 0.25 | 0.40 | 0.55 | 0.00 | 0.15 | 0.30 | 0.35 | 0.50 | 0.65 |
3. 复杂模型构建
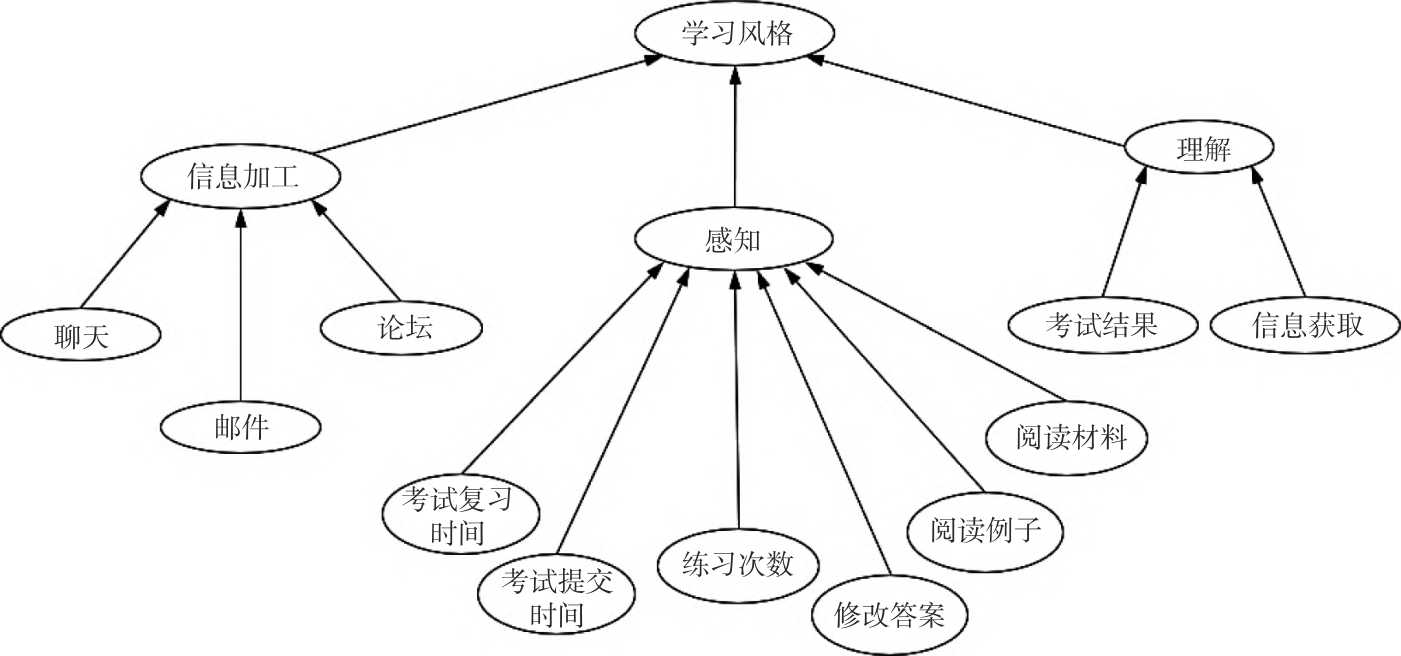
多维度、多层次的变量关系可纳入同一模型,连续/类别、正态/非正态数据均可处理。学习风格案例中,信息加工、感知、理解三个维度各分两类,由聊天、邮件、考试行为、修改答案等变量共同诊断,并可分块建模后整体评估:
4. 实时监测与反馈
传统时序模型(重复测量、纵向追踪、自回归、交叉滞后)在固定时刻需观测全部变量才能更新。贝叶斯网络在任意时刻、任意行为数据进入时即可更新模型,无需观测所有变量。论文认为这一特性支持对教育过程数据的实时评估。
5. 小样本与缺失数据
贝叶斯方法通过先验信息减小极端值影响;缺失数据可通过期望最大化(EM)算法估计条件概率。
算法与软件
结构学习算法分为三类:基于约束的(条件独立性检验)、基于评分的(AIC/BIC 信息准则)及混合算法。参数学习包括极大似然估计与贝叶斯后验估计,作者推荐后者以保持与整体贝叶斯方法的一致性。论文对主流软件的比较如下:
| 软件 | 平台 | 类别数据 | 连续数据 | 约束算法 | 评分算法 | 动态模型 | 参数估计 |
|---|---|---|---|---|---|---|---|
| bnlearn | R | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| Deal | R | ✓ | ✓ | ✗ | ✓ | ✗ | ✓ |
| pcalg | R | ✓ | ✓ | ✓ | ✗ | ✗ | ✓ |
| Banjo | Java | ✓ | ✗ | ✗ | ✓ | ✓ | ✗ |
| Free-BN | Java | ✓ | ✓ | ✓ | ✓ | ✗ | ✗ |
| BNFinder | Python | ✓ | ✓ | ✗ | ✓ | ✓ | ✗ |
| BNT | Matlab | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
应用案例:同伴关系与互助行为
论文以一项合作学习研究演示完整建模流程。样本为 22 名七年级学生,分 3 组进行基于合作推理讨论的 8 轮讨论(第 1 轮为预演,后 7 轮编码),共 21 次讨论,平均时长 27.5 分钟。互助行为编码为四类:讨论促进、行为支持、认知支持、情感支持;讨论前后测试同伴喜欢程度与同伴关系提名。
7 轮讨论中各类行为出现次数(括号内为占比):
| 互助行为 | T1 | T2 | T3 | T4 | T5 | T6 | T7 |
|---|---|---|---|---|---|---|---|
| 讨论促进 | 46 (32.9%) | 57 (40.7%) | 43 (30.7%) | 36 (25.7%) | 36 (25.7%) | 27 (19.3%) | 30 (21.4%) |
| 行为支持 | 24 (17.1%) | 31 (22.1%) | 39 (27.9%) | 32 (22.9%) | 36 (25.7%) | 35 (25.0%) | 25 (17.9%) |
| 认知支持 | 75 (53.6%) | 64 (45.7%) | 71 (50.7%) | 73 (52.1%) | 69 (49.3%) | 69 (49.3%) | 73 (52.1%) |
| 情感支持 | 40 (28.6%) | 41 (29.3%) | 36 (25.7%) | 25 (17.9%) | 42 (30.0%) | 30 (21.4%) | 39 (27.9%) |
| 总互助行为 | 185 | 193 | 189 | 166 | 183 | 161 | 167 |
该数据的特点在于:同伴关系既可能是互助行为的结果,也可能是其前因(学生更可能帮助关系好的组内同学);变量多为类别变量;样本量小(22 人)。这些特征使基于因变量为同伴喜欢程度的线性回归在理论上不成立。
贝叶斯网络的建模流程为:T1 时刻依据先验理论建网,T2–T6 时刻仅观测互助行为并预测同伴喜欢程度与同伴关系提名,T7 时刻用新测试数据更新模型:
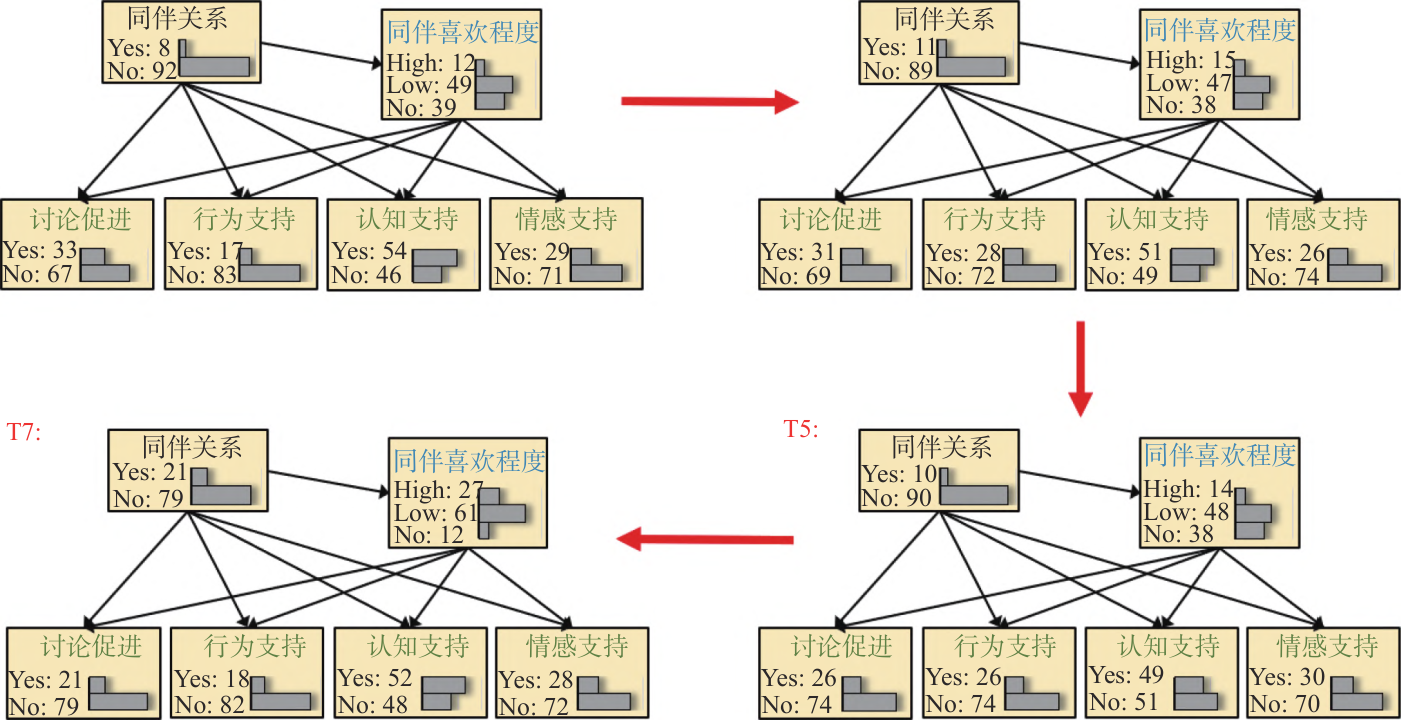
T1 时刻模型的条件概率表(表4):
| 变量 | 同伴关系提名 = 0 | 同伴关系提名 = 1 | ||||
|---|---|---|---|---|---|---|
| 喜欢 = 0 | 喜欢 = 1 | 喜欢 = 2 | 喜欢 = 0 | 喜欢 = 1 | 喜欢 = 2 | |
| P(同伴喜欢程度) | 0.418 | 0.527 | 0.055 | 0.015 | 0.015 | 0.884 |
| P(讨论促进 = 1) | 0.223 | 0.383 | 0.570 | 0.500 | 0.071 | 0.402 |
| P(行为支持 = 1) | 0.057 | 0.221 | 0.291 | 0.500 | 0.071 | 0.402 |
| P(认知支持 = 1) | 0.463 | 0.544 | 0.709 | 0.500 | 0.071 | 0.795 |
| P(情感支持 = 1) | 0.168 | 0.309 | 0.430 | 0.500 | 0.071 | 0.696 |
T7 时刻更新后的模型(表5),同伴关系提名的边缘概率由 T1 的 0.082 上升至 0.216:
| 变量 | 同伴关系提名 = 0 | 同伴关系提名 = 1 | ||||
|---|---|---|---|---|---|---|
| 喜欢 = 0 | 喜欢 = 1 | 喜欢 = 2 | 喜欢 = 0 | 喜欢 = 1 | 喜欢 = 2 | |
| P(同伴喜欢程度) | 0.155 | 0.680 | 0.165 | 0.006 | 0.333 | 0.661 |
| P(讨论促进 = 1) | 0.180 | 0.214 | 0.170 | 0.500 | 0.205 | 0.302 |
| P(行为支持 = 1) | 0.063 | 0.174 | 0.335 | 0.500 | 0.008 | 0.252 |
| P(认知支持 = 1) | 0.354 | 0.586 | 0.500 | 0.500 | 0.303 | 0.550 |
| P(情感支持 = 1) | 0.296 | 0.227 | 0.225 | 0.500 | 0.402 | 0.450 |
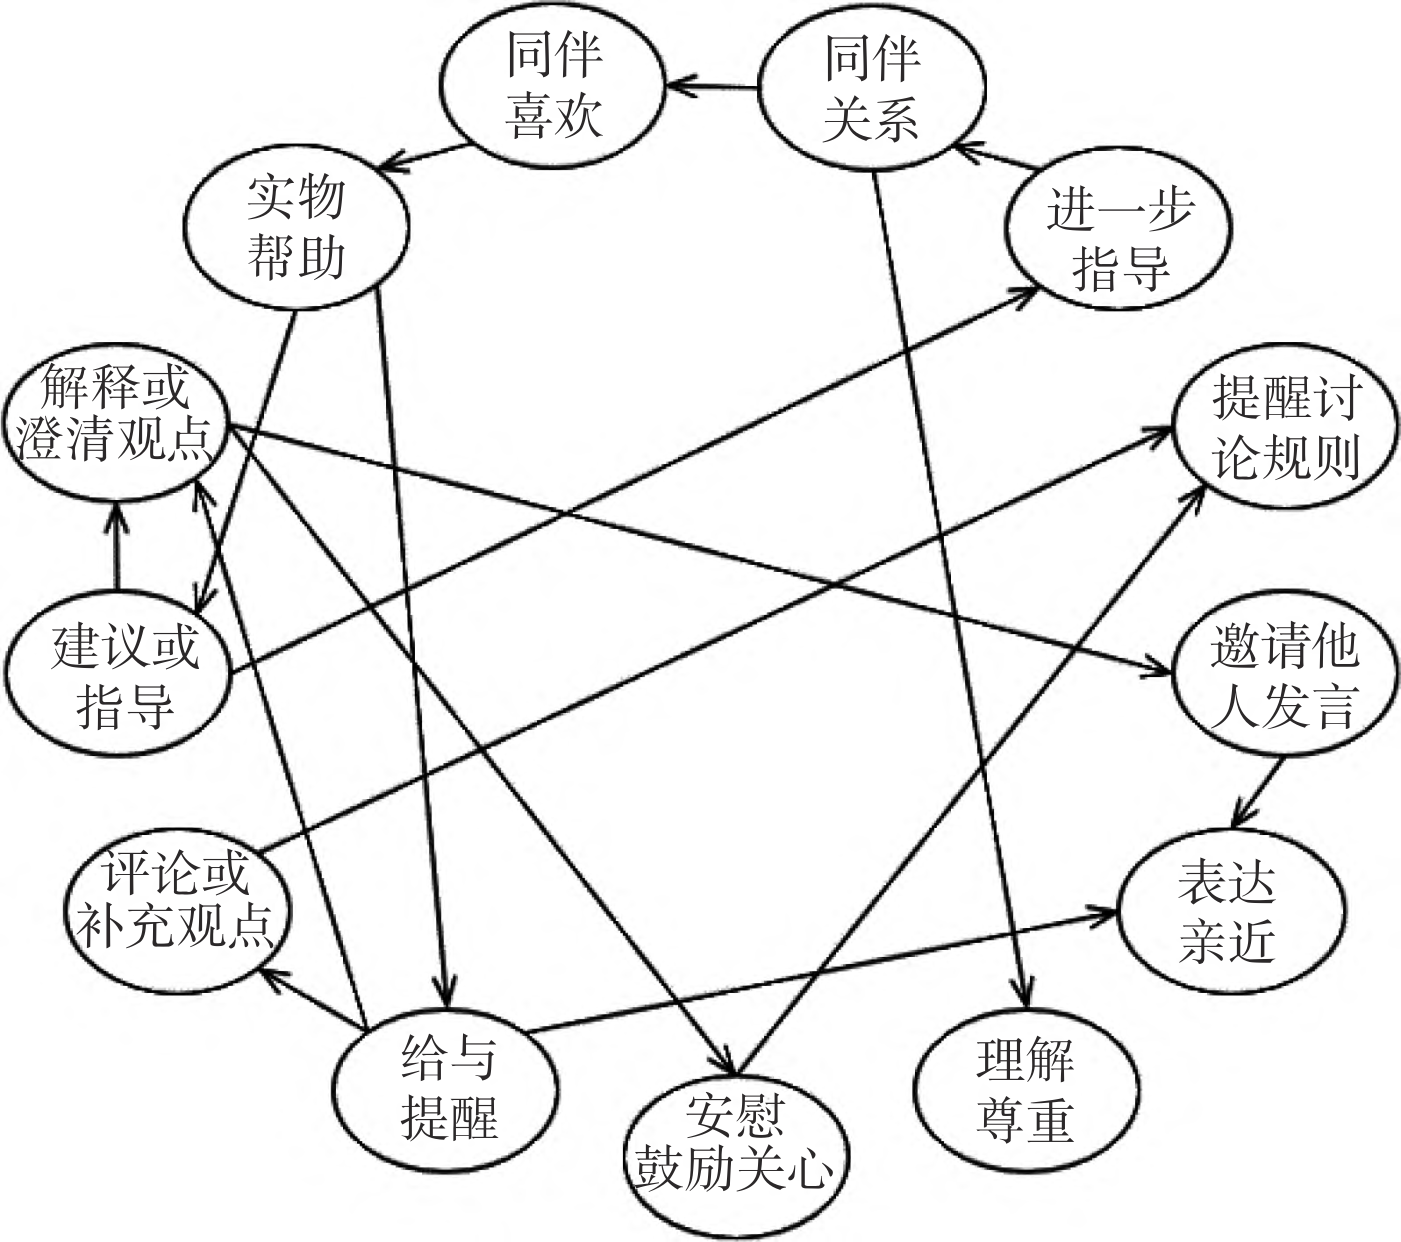
论文还演示了完全数据驱动的结构学习——不依赖先验知识直接从数据学习网络结构(图7),并指出该方式可能错误解释变量关系(如实物帮助与给予提醒之间并无因果),需要通过数据迭代修正:
精读笔记
核心论点:贝叶斯网络将不确定性与数据更新纳入教育实证研究的建模过程,将传统方法对“显著差异”的判断推进到对个体状态的概率推断。
方法要点:
- 以理论与专家经验构建先验模型,数据进入后迭代更新
- 结构学习分约束、评分、混合三类;参数学习推荐贝叶斯后验估计
- 可实现个体层面的概率推理、复杂模型构建、实时更新与小样本估计
局限与边界:
- 文中案例样本量小(22 人),演示性质大于统计推断
- 完全数据驱动的结构学习可能产生无法解释的变量关系,依赖先验或迭代修正
- 论文为方法综述与演示,未提供大规模实证检验的效应量
可延伸方向:将贝叶斯网络用于过程性评价数据(课堂行为、学习轨迹)的动态建模;与教育测量中的认知诊断模型结合。
概率无处不在,它允许我们从不确定和不完整的数据证据中做出复杂的统计推论。
原文地址
- DOI:10.16382/j.cnki.1000-5560.2022.11.009
- 期刊:《华东师范大学学报(教育科学版)》2022 年第 11 期,第 110—120 页