DeepSeek-V3.2:推进开放大语言模型的前沿
论文精读:DeepSeek-AI(2025)arXiv 技术报告——提出 DSA 稀疏注意力、可扩展强化学习框架与大规模智能体合成流水线三项关键创新,高算力变体性能对标 GPT-5。
文献:DeepSeek-AI (2025). DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models. arXiv:2512.02556. DOI 10.48550/arXiv.2512.02556。预印本(无 IF);Asta 引用快照 730(2026-09-04)。
研究问题:开放权重大模型能否同时做到“高算力效率”与“强推理/智能体性能”?论文要回答:如何在不牺牲性能的前提下降低长上下文计算成本?如何通过可扩展的后训练强化学习逼近甚至超越闭源旗舰模型?
论证思路:以“效率—能力兼顾”为主线,报告三项关键技术:
- DeepSeek 稀疏注意力(DSA):长上下文场景大幅降低计算复杂度并保持性能;
- 可扩展强化学习框架:扩大后训练算力后性能可比 GPT-5——高算力变体 V3.2-Speciale 超越 GPT-5、推理能力与 Gemini-3.0-Pro 相当,并在 2025 IMO 与 IOI 上取得金牌级表现;
- 大规模智能体任务合成流水线:系统化生成训练数据,提升复杂交互环境下的泛化与指令遵循能力。
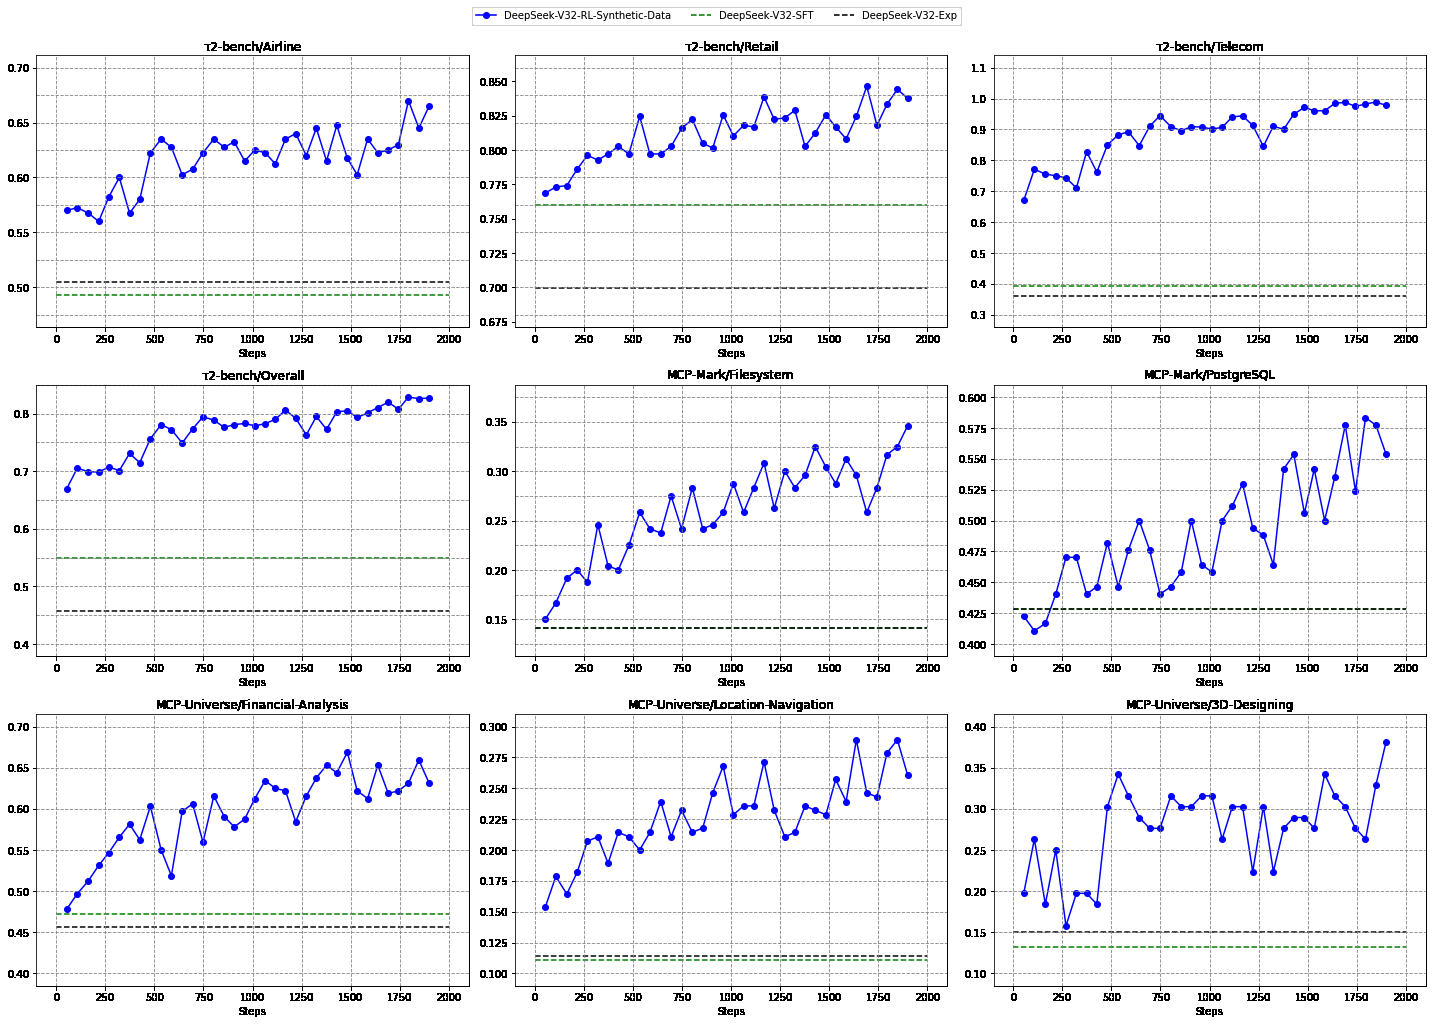
方法(性质提示):技术报告 + 厂商内部评测,预印本未经同行评议;基准对比(GPT-5、Gemini-3.0-Pro)均出自 DeepSeek 自述,需以第三方独立复现为准。
启示:
- 对研究者的实际价值在工程路径:稀疏注意力 + RL 后训练 + 合成数据流水线是可复现的开源配方(权重开放),适合本地部署与二次研究;
- 对教学/科研工具选型:开放权重旗舰模型的进步意味着大规模文本处理可脱离闭源 API,降低长上下文任务成本;
- 引用警示:所有性能对比为厂商声明,引用时必须标注“DeepSeek 自述 / 预印本未经同行评议”。