探索教师职业发展视角:Q 方法论研究
论文精读:Chaaban 等(2023)用 Q 方法论研究教师对职业发展的主观视角,通过 Q 排序与因子分析识别出多种教师职业发展观点类型,为教师发展政策设计提供方法学示范。
文献:Chaaban, Y., et al. (2023). Exploring teachers’ perspectives on career development: Q methodology research. Teaching and Teacher Education, 123, 104028. DOI 10.1016/j.tate.2022.104028。期刊 Teaching and Teacher Education(Elsevier),影响因子 3.9(Q1)。
研究问题:教师职业发展既是教师个体成长的议题,也是学校改进与教育质量的核心政策议题。然而政策制定者长期面临“众口难调”的困境:同一项培训制度或晋升机制,有的教师视之为机遇,有的教师视之为负担。以往研究多用问卷量表测量教师对职业发展的态度,得到的往往是“平均立场”——均值背后,不同教师对“什么才算好的职业发展”的理解差异被掩盖了。论文要回答的核心问题是:教师对职业发展究竟持有哪些不同的主观视角(subjective viewpoints)?这些视角能否被系统识别,并聚类为可描述、可解释的观点类型?
论证思路:论文选择 Q 方法论(Q methodology)作为研究策略,其独特之处在于不把“职业发展观”拆成研究者预设的维度来逐项打分,而是让教师对一组覆盖培训进修、职务晋升、专业学习社区、自主发展等途径的陈述进行“最同意 → 最不同意”的强制排序(Q 排序),把每位教师的排序视为其主观价值结构的整体表达;随后对“人 × 人”相关矩阵作因子分析,把排序方式相似的教师聚为同一观点类型(因子),并以因子数组(factor array)重建每种类型的“理想排序”。整个论证遵循“主观性优先、让观点自己浮现”的逻辑——先收集陈述,再让教师排序,最后以因子解释视角结构,而不是用理论预设去裁剪教师的真实看法。
一、Q 方法论:研究主观视角的独特方法
Q 方法论由心理学家 William Stephenson 于 1935 年提出,是社会科学中少数以“主观性”本身为研究对象的正式方法。理解它的最好方式是把它与主流测量传统对照:
- R 方法论(questionnaire/rating 传统):让大量被试回答少量问题,分析“题 × 人”数据矩阵,关注变量之间的相关(如“工作满意度与离职意向的相关”),把人当作特质的载体;
- Q 方法论:让少量参与者对大量陈述排序,分析“人 × 人”相关矩阵,关注人之间的相关——把“人”当作变量,把每位参与者对一组陈述的整体排序当作其观点的操作化表达。
Q 方法论的核心主张是:主观性是可以被科学研究的——一个人的“观点”,就是他对一组陈述的相对排序;这个排序本身既是数据,也是立场。这一立场带来三个突出特点:
- 小样本即可:P 集合(参与者)通常只有 20–60 人,不追求人口代表性,而追求观点多样性——关键在于把可能存在的各种看法都纳入;
- 混合方法气质:量化环节(相关、因子分析)与质性环节(排序后的评语、访谈解释)结合,既有统计严谨性,又有解释深度;
- 回答“存在哪些类型”:它回答“教师群体中存在哪些职业发展观”,而非“哪种观点在总体中占多大比例”——后者需要另外的大样本问卷。
对本文议题而言,Q 方法论格外合适:“职业发展”是一个高度主观、多歧义的概念——“发展”对每位教师意味着不同的东西,有的指向职位,有的指向能力,有的指向关系,有的指向稳定。Q 方法恰好能把这种“不同的意味”系统地呈现出来,而不是预先假设一个统一答案。
二、Q 方法论的完整步骤详解
这是本文最值得精读的方法学价值点。Q 方法看似简单(“不就是让人排个序”),实则每一步都有严格的技术要求:
第一步:构建 Q 集合(concourse 与 Q sample)。 先尽可能全面地收集关于“教师职业发展”的所有可设想观点陈述(concourse)——来源包括文献、政策文本、访谈与开放性问卷;再从 concourse 中按主题分层筛选出有代表性的陈述子集(Q sample,通常 40–60 条),确保覆盖职业发展的各个面向:培训进修、职务晋升、专业学习社区、自主发展、外部认可、工作条件等。Q 样本的质量直接决定后续因子结构,这是整个研究的地基。
第二步:选择 P 集合(参与者)。 与随机抽样相反,Q 方法采用有目的抽样:选取在教龄、学科、学段、学校类型、职业阶段等背景上尽可能多样的教师,以保证观点谱系完整。参与者数量不必大,但多样性必须足。
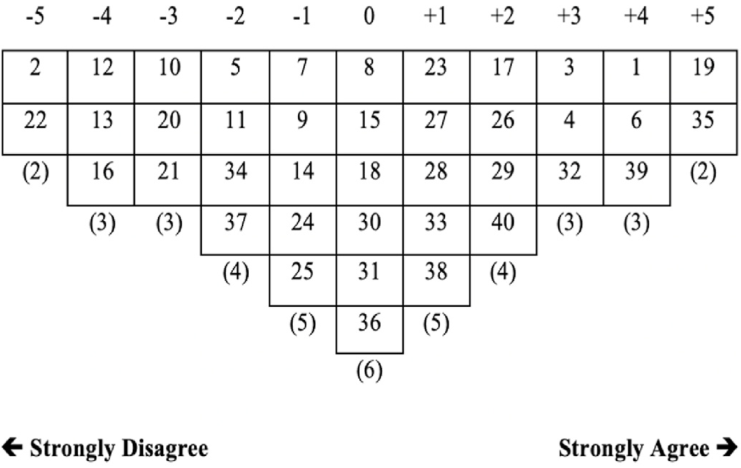
第三步:Q 排序(Q sorting)。 每位参与者把全部陈述按“最同意 → 最不同意”放入准正态分布的排序网格(例如从 −5 到 +5,两端名额少、中间名额多)。强制分布的关键意义在于:迫使参与者做相对判断——不能“全都同意”,必须排出优先级。这一步把抽象的“价值排序”转化为可分析的数字,是 Q 方法最精巧的环节。排序后,研究者常请参与者说明极端位置(最同意/最不同意的陈述)的理由,为后续解释积累质料。
第四步:相关矩阵与因子提取。 计算参与者两两排序之间的相关,得到“人 × 人”相关矩阵——这是 Q 方法与 R 方法最本质的分野。随后对该矩阵做主成分分析或质心法因子分析,依据特征值(Kaiser 准则)、碎石图与可解释性决定保留的因子数。本文得到多个因子(F-1、F-2 等),每个因子代表一种共享的观点模式。
第五步:因子旋转与参与者归类。 通过 varimax 等旋转使因子结构清晰,再计算每位参与者在各因子上的载荷(factor loadings):显著载荷于某因子的参与者被归入该观点类型;未显著载荷于任何因子的参与者被视为“混杂者”,不进入类型画像。
第六步:因子数组(factor array)。 把归入同一因子的参与者对每条陈述的得分加权平均(计算 z 分数),再映射回排序网格,得到该因子的理想 Q 排序——即原文 Figure 2 所示的因子数组。因子数组是每个观点类型的浓缩画像:一眼可见该类型教师对培训、晋升、专业学习社区等各条陈述的相对价值判断,是解释与命名因子的核心依据。
第七步:区分陈述与共识陈述。 区分陈述(distinguishing statements)指在某一因子的数组得分与其余因子有统计显著差异的陈述——它们勾勒每个视角的独特性;共识陈述(consensus statements)指各因子得分无显著差异的陈述——它们揭示全体教师共享的价值底线。
第八步:解释与命名。 结合因子数组、区分/共识陈述与参与者的评语或访谈,为每个因子撰写“观点画像”并命名,最终形成可读的视角类型描述。Q 研究在统计结束之后才真正开始——因子只是骨架,解释与命名赋予其血肉。
三、核心发现:教师职业发展的多种观点类型
因子分析识别出多个稳定的观点类型(F-1、F-2 等),说明教师对职业发展的理解并非铁板一块,而是存在若干系统性的“看法簇”。各类型在“什么构成好的职业发展”上价值排序迥异:
- 有的类型最看重培训进修与专业成长——把持续学习本身视为发展,对正式的学时、证书与知识更新敏感;
- 有的类型最看重职务晋升与职业阶梯——把正式地位的提升、岗位流动与职业前景视为发展的核心;
- 有的类型最看重专业学习社区与同伴协作——把关系中的成长、同事互学与共同体归属视为发展;
- 还有的类型更看重工作条件、稳定与工作—生活平衡——把“可持续地做教师”本身视为发展。
因子数组(原文 Figure 2,以 F-1 为例)直观呈现了这些排序差异:同一组陈述,在不同观点类型下被置于排序网格的不同位置——同一句“学校应提供更多晋升机会”,在某一类型中是最高优先,在另一类型中可能只是中位选项。
与此同时,共识陈述提示了共同点:无论哪个类型,教师对“持续专业发展”的必要性、对学校支持性条件的期待都存在共享的底线。因此本文的核心结论可以概括为:教师职业发展需求是“多型”的——任何单一制度设计都不可能满足所有教师;政策与实践需要以“视角”为单位来理解教师,而不是以“平均教师”为单位。
四、对教师发展政策设计的启示
- 告别“一刀切”。既然存在多种观点类型,教师发展政策与学校实践就应提供多元路径:既有正式的晋升阶梯与学时制培训,也有专业学习社区、同伴指导、自主项目等非正式途径,让不同取向的教师各得其所;
- 用 Q 方法做“视角诊断”。在制定区域或校本教师发展方案前,可先用 Q 方法(小样本即可)摸清教师群体的视角结构,据此设计组合式方案,而非凭经验猜测需求;
- 重视“非正式”发展途径。专业学习社区等同伴协作途径对相当一部分教师而言价值不亚于晋升与培训——政策评估不能只盯着培训学时与晋升率这两类正式指标;
- 把“价值排序”纳入对话。让教师参与发展路径的设计,尊重其在“成长、晋升、协作、稳定”之间的排序差异,能显著提升发展项目的吸引力与教师留任意愿;
- 以共识陈述为底线。类型之间存在差异,但也存在共享共识;政策应首先守住共同底线(公平的机会、基本的支持性条件),再谈差异化供给。
精读笔记
核心论点:教师对职业发展的主观视角存在多种可系统识别的类型(F-1、F-2 等);Q 方法论能够把主观价值排序转化为可分析的数据并聚类为观点类型,为“差异化的教师发展政策”提供实证依据——教师职业发展研究不应停留在“平均水平”,而应抵达“视角结构”。
方法要点:
- Q 方法论以“人 × 人”相关矩阵与因子分析取代“题 × 人”的经典测量逻辑,把每位参与者的 Q 排序当作其主观立场的整体表达;
- 关键环节环环相扣:concourse → Q sample 的陈述构建 → 准正态强制分布的 Q 排序 → 因子提取与旋转 → 因子数组重建 → 区分/共识陈述分析 → 解释与命名;
- 小样本、混合方法、“让观点自己浮现”——特别适合研究主观性强、多义的概念;
- 因子数组(原文 Figure 2)是呈现与解释观点的核心载体,把抽象的统计结果还原为可读的价值排序。
局限与边界:
- Q 方法回答“存在哪些观点类型”,不能回答每种类型在总体中占多大比例——比例问题需另用大样本问卷测量;
- 因子结构与 Q 样本的陈述构成高度相关:换一组陈述,可能得到不同的因子结构;
- 参与者来自特定教育背景(卡塔尔公立学校教师等,具体抽样信息以原文为准),结论向其他教育系统外推需谨慎;
- 强迫分布的 Q 排序可能损失个体排序的细微信息;因子解释依赖研究者的判断,带有一定主观性。
可延伸方向:
- 把 Q 方法用于其他教育主体的视角研究:学生、家长、校长、教研员对同一议题(如评价改革、AI 进课堂)的不同立场;
- Q + 大样本两阶段设计:先以 Q 方法识别观点类型并据此编制量表,再在大样本中测量各类型的分布与影响因素;
- 纵向 Q 研究:追踪政策实施前后教师视角结构的变化,评估政策是否改变了观点的格局;
- 把“多型视角”框架用于 AI 时代的教师专业发展——不同教师对 AI 的接受与使用取向同样适合用 Q 方法识别;
- 交叉分析:把观点类型与教师背景(教龄、学科、学校类型)对应,考察视角的群体来源。
原文地址
- DOI:10.1016/j.tate.2022.104028
- 期刊:Teaching and Teacher Education(Elsevier),Vol. 123(2023),Article 104028;IF 3.9(Q1)
- 图表来源:原文 Figure 2(因子数组,factor arrays)