GPT 作为测量工具:用语言模型给定性数据打分,能否达到人类标注者的水准
论文精读:Asirvatham、Mokski 与 Shleifer(2026,NBER WP 34834)以自研工具包 GABRIEL 检验 GPT 作为测量工具的两项要求——准确性(与人类标注一致)与直接性(读文本本身,而非依赖记忆或相关线索),验证材料包括 300 余个真实标注数据集与 1,141 个二分类任务。主要结论:GPT 标注与人类共识的一致性不低于单个标注者之间的一致性;训练截止前后无污染迹象;剥离信号后评分衰减 98%;作者并用该工具组装 37,000 项技术的数据集,量化出「从发明到普及」的滞后期在一个半世纪内缩短十倍。
文献:Asirvatham, H., Mokski, E., & Shleifer, A. (2026). GPT as a measurement tool. Working paper(亦列为 NBER Working Paper 34834,2026 年 2 月版,共 99 页)。
原文:NBER · GPT as a Measurement Tool|工具包:github.com/openai/GABRIEL(开源)
研究问题:把语言模型的输出当作数据使用时,测到的究竟是什么?作者把这一问题拆成两项可比检验的要求:
- 准确性(accuracy):给定输入,模型的测量应与公认基准一致——主观构念以人类标注为基准,有外部真值的构念(信用分、选举结果)以客观结果为基准;
- 直接性(directness):测量应由文本本身的信号驱动,而非来自训练数据泄漏、记忆事实,或「相关线索的猜测」(即绕开研究者想让它读的内容)。
为什么值得细读:这是一篇方法论文——它不提出新的社会理论,而是系统检验「LLM 作为测量仪器」能否成立,并给出可操作的验证流程与操作清单。对需要用开放式问卷、访谈、政策文本、课程文件做编码的教育与社科研究者,它回答的正是「我能不能用 GPT 编码、以及怎样才站得住」这个问题。
一、GABRIEL 是什么:不是模型,而是「把 GPT 变成仪器」的封装
GABRIEL(Generalized Attribute-Based Ratings Information Extraction Library)不训练、不微调任何模型,它是对现有语言模型 API 的提示词封装:每个函数(评分、排序、分类、段落编码、信息抽取)对应一个提示模板,由模型完成推理,GABRIEL 负责把同一个问题以完全相同的措辞、输出结构与参数问遍整个语料,并返回结构化表格。作者用了一个类比:GABRIEL 之于 GPT,类似 Stata 之于回归——没有秘密配方,价值在于标准化、规模、可及性与「经过验证的参照点」。
- 规模:并行调用 API,数万条语料可在数分钟内完成;
- 成本:按人类阅读速度文献(Brysbaert, 2019)与 $15/小时的众包定价估算,使用最便宜但性能仍高的模型可降低成本约 17,500 倍,即使用最贵的模型也便宜约 700 倍;
- 面向非技术用户:输出为标准表格,可直接进入定量分析。
二、验证设计的规模
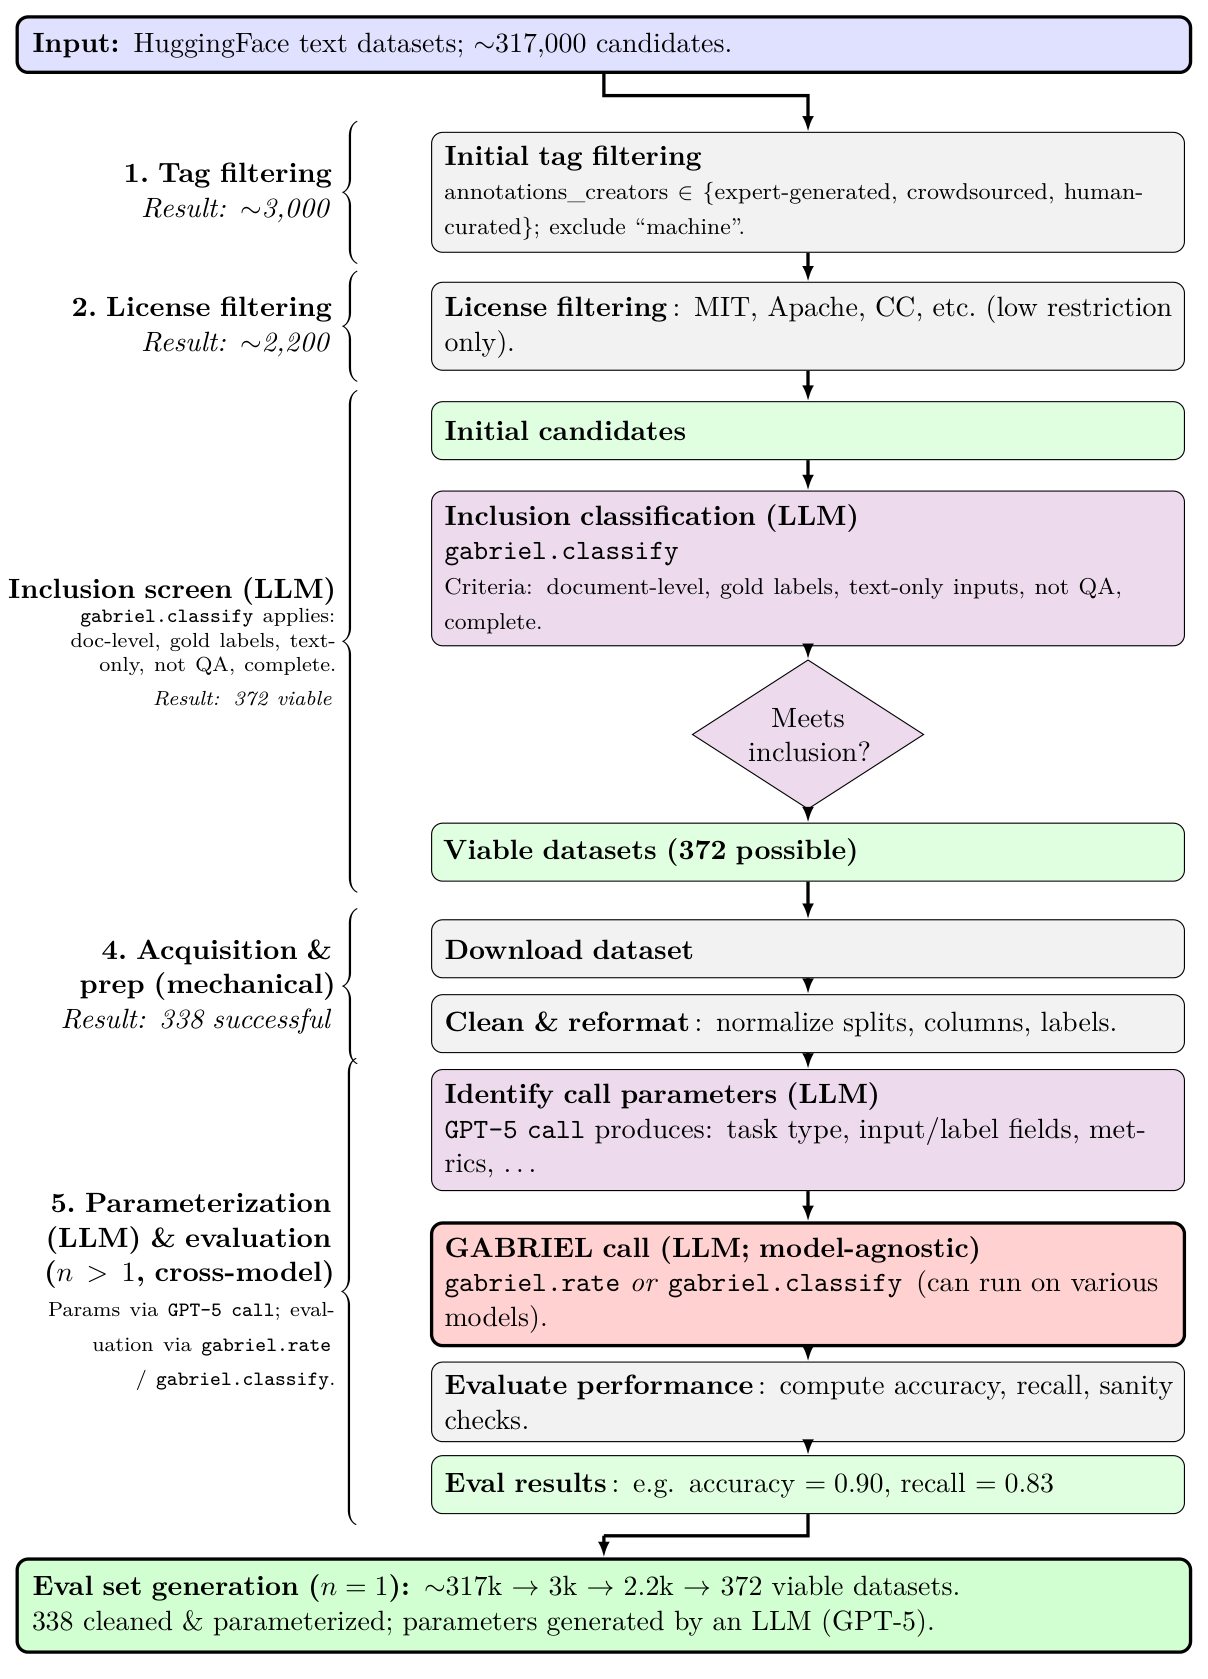
四个示范数据集(均有多人标注,可测量人类评分者之间的自然分歧):Varieties of Democracy(专家编码,200 余个国家与地区、1789 年至今、3 万余个国家—年观测;本文取 21 个变量、抽 10,000 个国家—年);Formality(Pavlick & Tetreault, 2016;11,274 句);Stanford Politeness Corpus(10,956 条话语);Metacritic 影评(从评论文本预测 0–100 分)。
大规模复制:作者从 HuggingFace 汇总约 300 个全文标注数据集,其中 1,141 个二分类任务(每个任务最多 200 条文本)用于检验「泛化性」——即模型能否在毫不相关的题材之间保持同等水准。
三、准确性:与人类共识的一致性不低于人类彼此之间
- 相关性(gpt-5 与人类共识):形式度 0.78、21 个 vDem 变量平均 约 0.71、礼貌度 0.55、Metacritic 0.7–0.8 以上;越新的模型越好。
- 关键检验(HH vs MH):把「模型与人类共识的相关」同「单个标注者与其余标注者共识的相关」相比——人类—人类一致性并未超过模型—人类一致性。在 23 个受测变量上,gpt-5 有 13 个优于人类(12 个 vDem 变量+礼貌度)、3 个落后(2 个 vDem 变量+形式度)、7 个在统计上无法区分。作者的解读是:这类任务本身容许大量裁量空间,因此 0.7 以上的相关已接近天花板。
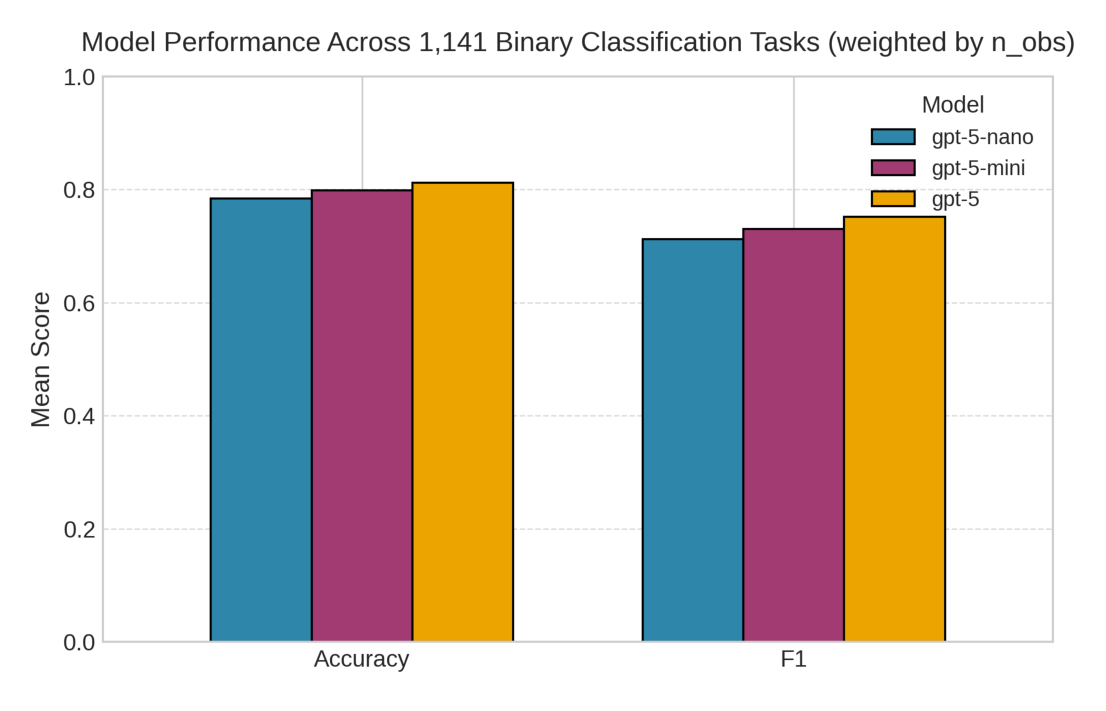
- 大规模表现:领先模型中位准确率 0.85,四分位区间约 0.7–0.95;即使第 10 百分位的任务,准确率仍在 0.5 上下或以上。
- 性能来自推理而非记忆:同代中更小的蒸馏模型(gpt-5-mini)仅略逊于 gpt-5,且优于体积更大但缺少推理能力的 gpt-4o——若答案是「背出来的」,无法解释这一模式。
四、稳健性与两项效度检验
提示词稳健性:作者构造 100 个语义等价的提示变体(含不足 100 词的极简提示),测量结果基本相同——「提示词写得好不好」在这一评分式(rubric-based)测量场景中收益有限。
污染检验:利用不同模型训练截止日期(最早回溯至 2021 年,最新覆盖至 2024 年)构成的错位比较,检验「数据集发布在训练截止之前 vs 之后」的准确率差异——没有任何模型出现统计上显著的衰减(准确率与 F1 均如此),作者据此认为污染不是这些任务上准确率的主要来源。
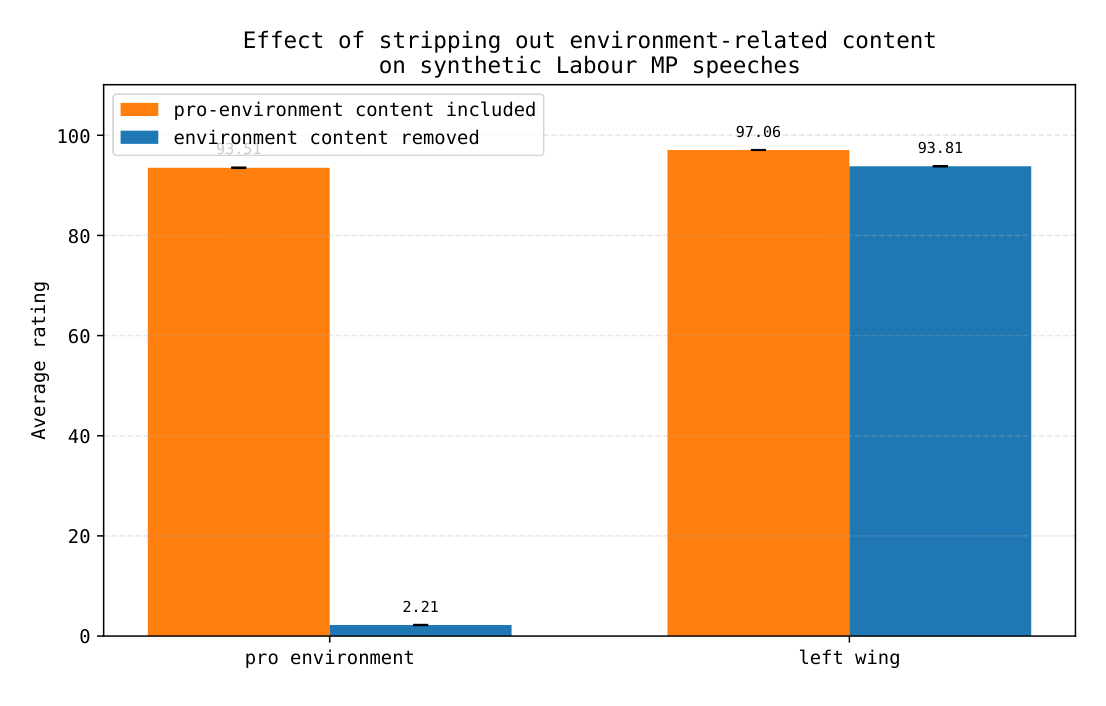
捷径推断检验:作者另建 gabriel.debias 方法在真实文本上做同类检验(如地方商业管制报告),结论一致——去偏前后评分变化很小。作者提醒这并不证明偏误为零(低统计功效对这些偏误敏感),但认为「从相关线索猜答案」在实践中不是主要问题。
五、实质应用:技术采纳史(37,000 项技术)
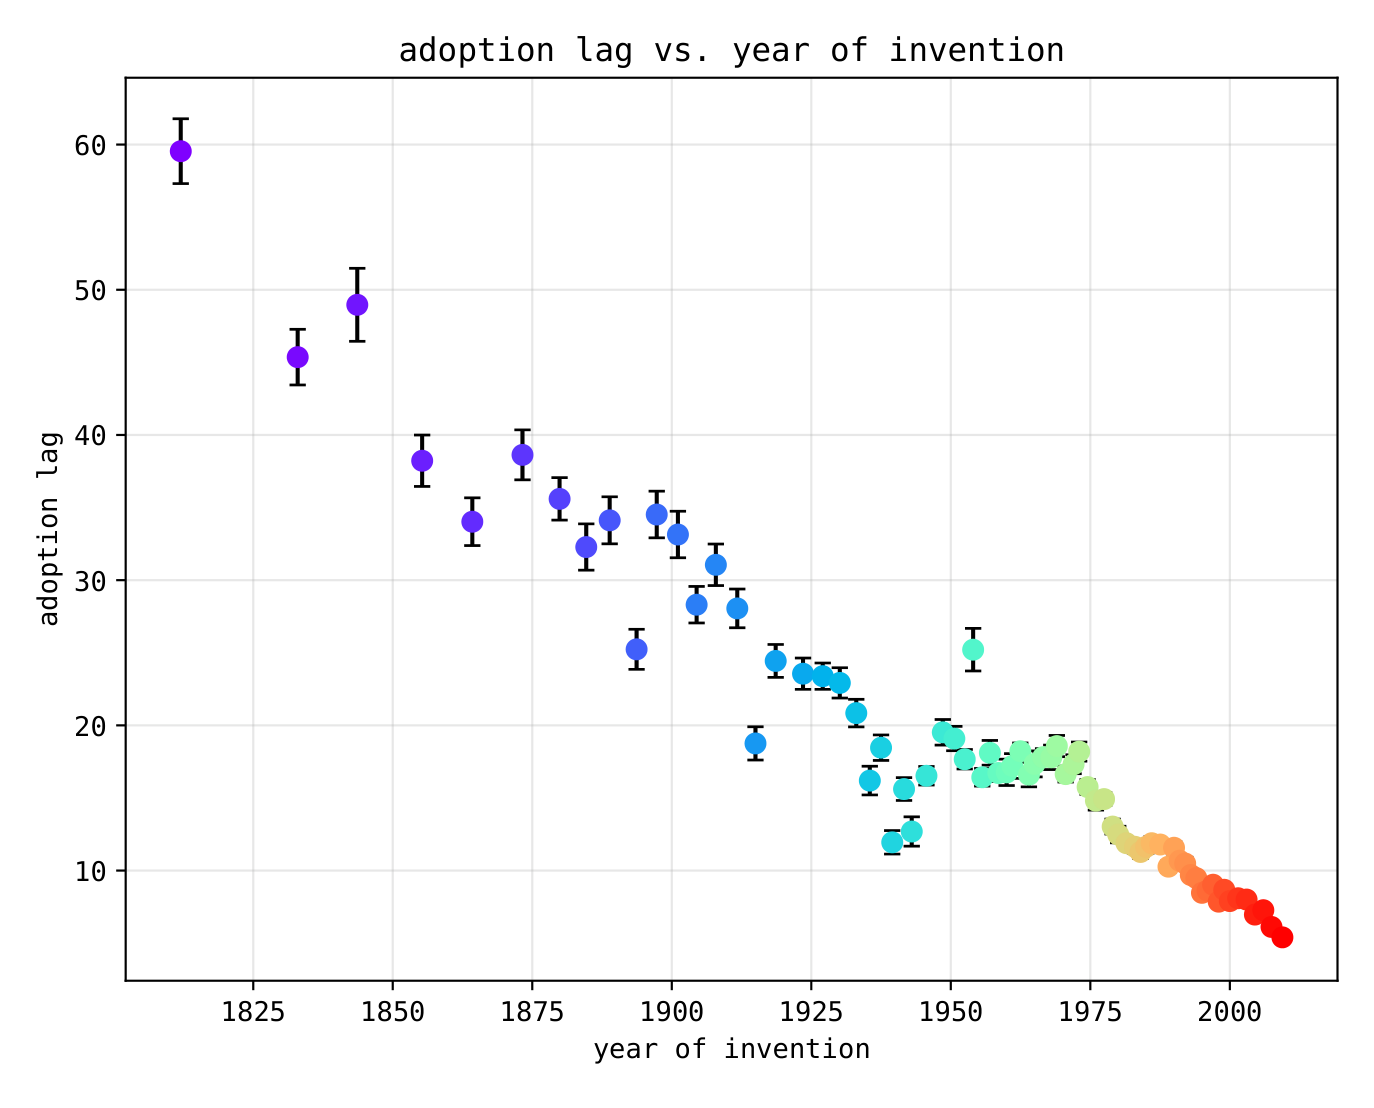
- 数据集规模:既有历史技术采纳数据集通常仅数百项技术,本文组装了 37,000 余项技术及其多项定性属性的量化评分;
- 核心发现:采纳滞后从 19 世纪的 40–60 年降到 21 世纪的约 5 年(十倍);回归中「发明年份」系数 −0.224*(SE 0.004),N = 24,431,R² = 0.254;
- 谁更快:军事技术比同期其他技术快约 27%,机构类型上军事与企业的技术更快、学术机构最慢;
- 属性解释力:复杂供应链、依赖网络效应、包含大量部件等与更长滞后期相关;竞争性、地缘政治驱动、迭代式技术与更短滞后期相关;作者自陈两个反直觉结果——需要专门训练的技术反而更快、易用技术反而更慢;
- 全部测得的属性合计解释了超额滞后变异的 23%。作者明确说明这些是描述性结果、部分变量可能内生,不是因果结论。
六、作者给研究者的操作清单(附录 B)
- 大胆用,但要把它当测量:GPT 是测量工具而非魔法,测量效度(本文所验证的)与统计效度(取决于研究设计)必须分开评估;
- 先读样本再设计属性:短文本宜用更简单的属性,或按作者聚合(如把同一用户的 15 条推文合成一条观测);
- 先在 ChatGPT 里试:小样本能跑通再上规模;小规模人工校验仍有价值但多数情形不必全面校验;
- 最大的新风险是 p-hacking——由于测量近乎免费,很容易试上百个属性或属性变体后只报告显著者。作者建议:留出测试集(例如在 50% 的训练子样本上做全部探索、定稿后再在留出集上跑并报告)、记录所有测过的属性及其变体与总数、并按多重比较的实际情况调整显著性阈值。
精读笔记
核心论点:在本文检验的范围内,GPT 的标注不比一个典型人类标注者更差,且往往更接近人类共识;因此凡是可以接受人类标注误差的研究场景,LLM 标注是可用的替代品——但前提是把它当作测量来对待:报告属性定义、记录全部尝试、并保留验证数据。
方法层面值得学习的三点:
- 「人类—人类一致性」作为基准线:不是问「模型与人类相关多高」,而是问「模型与共识的一致性是否低于单个标注者之间的一致性」。这一基准线比任何绝对阈值都更有说服力,也可直接迁移到自建编码任务的效度论证中。
- 两类效度的分离检验:准确性(与基准一致)+直接性(剥离信号后评分是否衰减)。剥离信号的实验设计尤其值得借鉴——它把「模型是否真的在读我指定的内容」变成了可观测的对照实验,而不是靠讨论来论证。
- 把测量成本下降带来的新风险写进方法:作者没有停留在「更好更便宜」,而是明确指出低成本测量会放大 p-hacking,并给出留出集与记录清单的操作方案。
对教育研究的迁移价值:开放式问卷、访谈转录、课程与政策文本、课堂话语编码,都是本文方法的直接适用对象。若要用于自己的研究,最小可行流程是:先读样本定属性 → 小样本人工校验 → 在探索子样本上定稿属性 → 在留出集上报告结果 → 记录所有尝试过的属性与变体。
局限与引用提示:
- 本文为工作论文,未见同行评议记录;
- 作者与研究对象的利益关系需如实标注:两位作者任职于 OpenAI,评估的是 OpenAI 自家模型(论文亦声明观点不代表所属机构);尽管验证材料大量来自独立数据集,仍属利益相关方自评,引用时应与独立第三方复现研究区分;
- 作者自陈证据不完整(「语言模型是新的,证据尚不完整」),且技术采纳部分为描述性分析、非因果;
- 结论的适用边界是**「评分式测量」**:作者明确指出提示工程的收益有限这一结论限于 rubric-based 测量,不适用于多步推理、工具调用等其他任务类型。
来源:桌面积读文献|原文 PDF《GPT as a measurement tool》(99 页,2026 年 2 月版)已按本卡片要点核对(摘要、第 2—6 节、附录 B,以及图 12、13、23、28)