基于扩展 UTAUT 模型的 AI 健康助手用户采纳影响因素研究
论文精读:Su 等(2025)基于 373 名中国普通用户问卷,用扩展 UTAUT 模型(加入感知信任与感知风险)揭示 AI 健康助手的采纳机制。
文献:Su, J., Wang, Y., Liu, H., Zhang, Z., Wang, Z., & Li, Z. (2025). Investigating the factors influencing users’ adoption of artificial intelligence health assistants based on an extended UTAUT model. Scientific Reports, 15, Article 18215. DOI 10.1038/s41598-025-01897-0。
研究问题:AI 健康助手(能解读自然语言指令、提供健康管理建议的智能体)正快速进入医疗健康领域——从慢性病自我管理到心理健康聊天机器人(如 Woebot)。但普通用户对 AI 健康助手的接受意愿仍缺乏实证研究。论文要回答:哪些因素影响用户使用 AI 健康助手的意愿?信任与风险感知在其中起什么作用?
论证思路:基于技术接受与使用的统一理论(UTAUT),扩展加入**感知信任(PT)与感知风险(PR)**两个变量,在线招募 373 名中国普通用户,用协方差结构方程模型(CB-SEM)检验假设。
一、理论框架
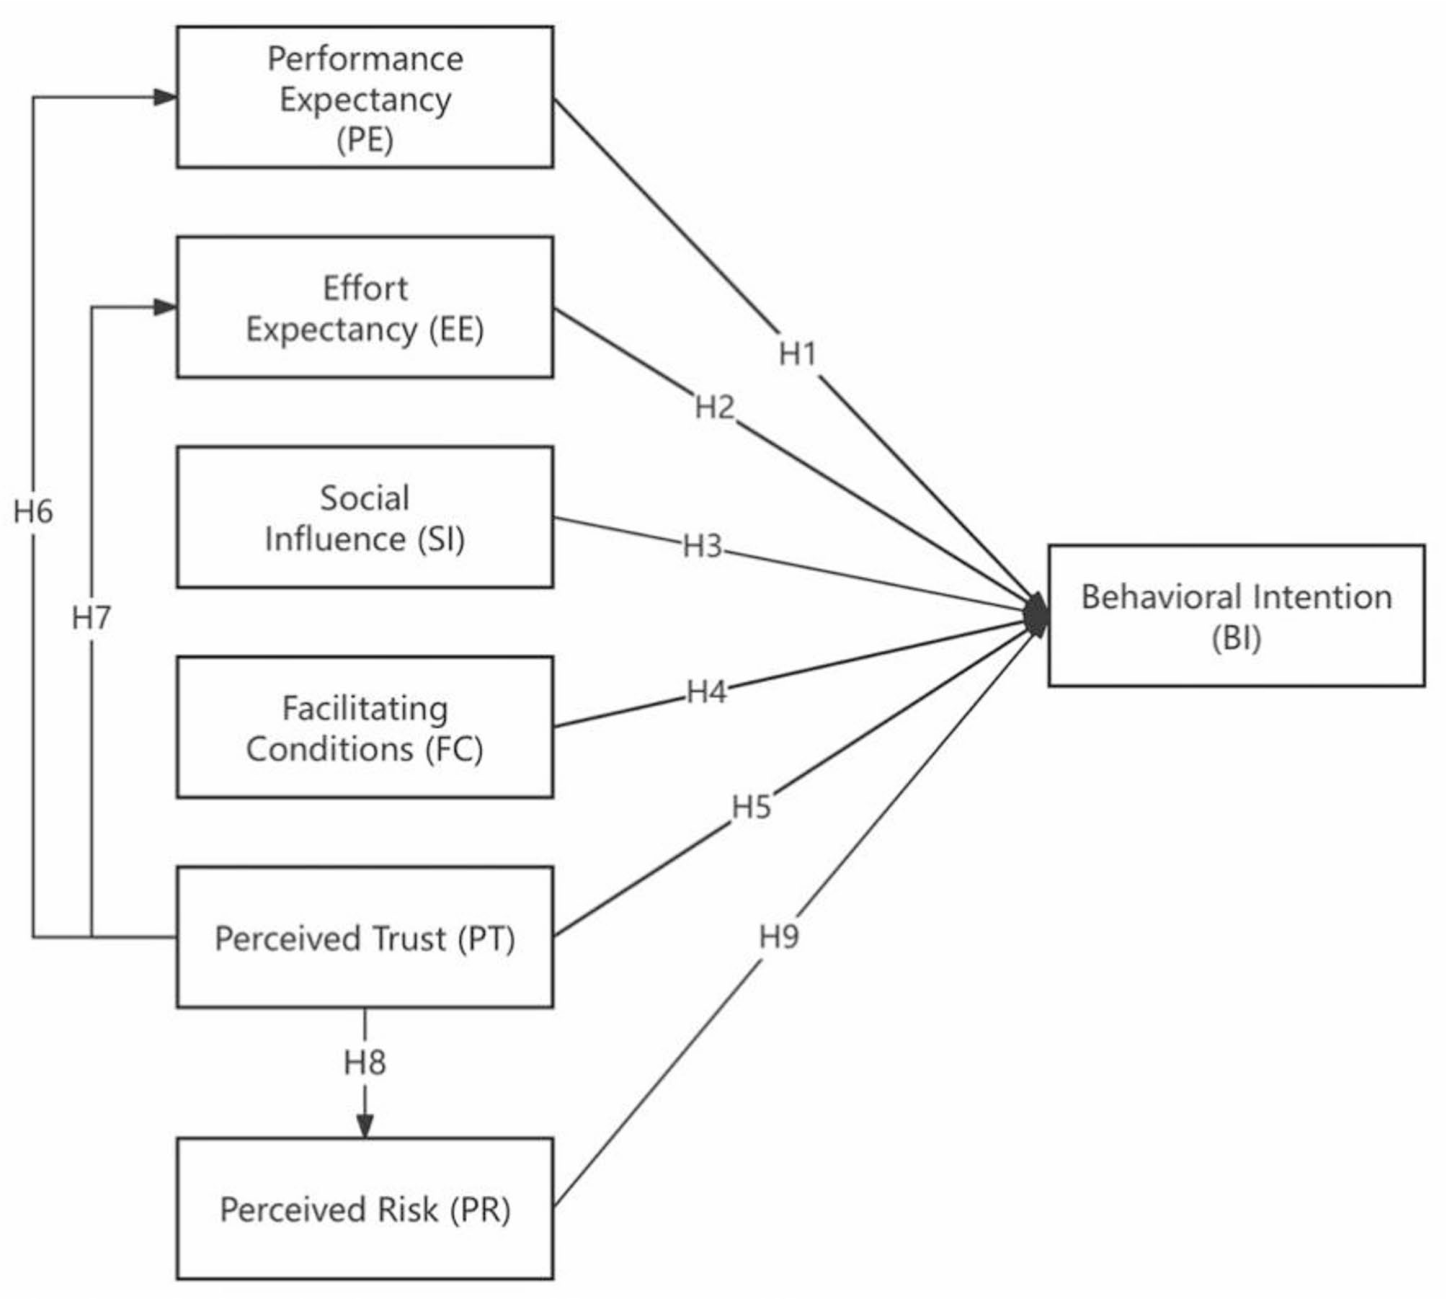
UTAUT 的核心构念:绩效期望(PE)、努力期望(EE)、社会影响(SI)、促进条件(FC) → 行为意愿(BI)。本研究在此基础上加入:
- 感知信任(PT):用户对 AI 健康助手可靠性的信任——同时影响绩效期望、努力期望与行为意愿;
- 感知风险(PR):使用带来的隐私、健康风险担忧——负向影响行为意愿。
二、样本与方法
- 样本:在线招募 373 名中国普通用户(19–39 岁占 80.7%)
- 分析:CB-SEM;模型拟合良好(原文 Table 6):χ²/df = 1.443、CFI = 0.984、TLI = 0.981、NFI = 0.950、RMSEA = 0.035、SRMR = 0.037——全部优于推荐阈值。
三、核心发现
1. 原 UTAUT 结构稳健(原文 Table 7)
| 假设 | 路径 | β | SE | t | 结果 |
|---|---|---|---|---|---|
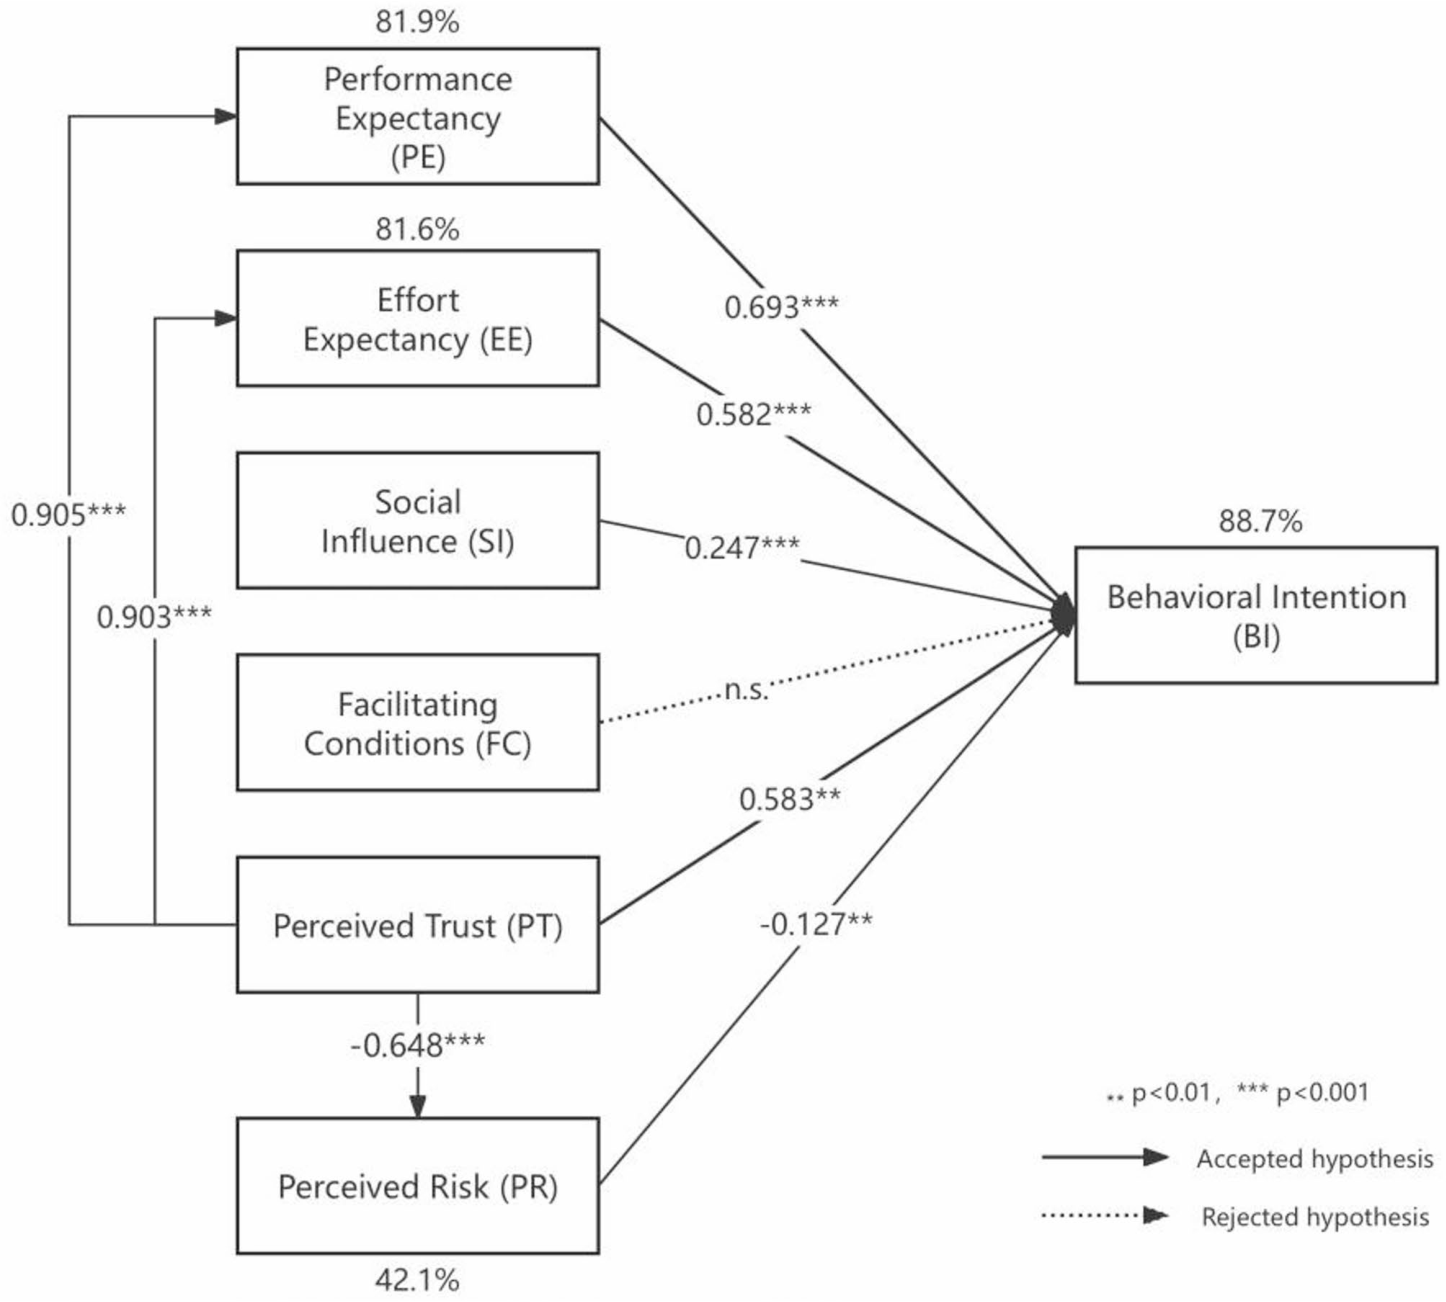
| H1 | 绩效期望 → 行为意愿 | 0.693*** | 0.133 | 4.874 | 接受 |
| H2 | 努力期望 → 行为意愿 | 0.582*** | 0.132 | 4.146 | 接受 |
| H3 | 社会影响 → 行为意愿 | 0.247*** | 0.064 | 3.403 | 接受 |
| H4 | 促进条件 → 行为意愿 | 0.01 | 0.074 | 0.121 | 拒绝 |
| H5 | 感知信任 → 行为意愿 | 0.583** | 0.270 | 2.141 | 接受 |
| H6 | 感知信任 → 绩效期望 | 0.905*** | 0.065 | 14.700 | 接受 |
| H7 | 感知信任 → 努力期望 | 0.903*** | 0.066 | 14.375 | 接受 |
| H8 | 感知信任 → 感知风险 | −0.648*** | 0.081 | −11.196 | 接受 |
| H9 | 感知风险 → 行为意愿 | −0.127** | 0.034 | −2.612 | 接受 |
2. 关键结论
- 绩效期望最强(β = 0.693)——用户最看重 AI 健康助手“有没有用”;
- 促进条件不显著——与多数 UTAUT 研究不同,这里“基础设施支持”并未显著影响采纳意愿,可能因为 AI 健康助手多为手机 App,使用门槛低;
- 感知信任是核心枢纽:对绩效期望(0.905)、努力期望(0.903)、行为意愿(0.583)均为强正向,同时显著降低感知风险(−0.648)——信任既直接促进采纳,又通过“化解风险担忧”间接促进;
- 感知风险负向但较弱(−0.127)——用户虽有风险顾虑,但不足以主导采纳决策。
模型解释力:PE、EE、SI、PT、PR 共同解释了行为意愿 88.7% 的方差;PT 单独解释了 PE 的 81.9%、EE 的 81.6%、PR 的 42.1%。
四、实践启示
对开发者:建立用户信任是重中之重——信任同时驱动“有用感”、“易用感”并压制风险担忧。清晰说明数据用途、提供可靠的健康建议来源、透明化 AI 的能力边界,都能增强信任。
对运营者:绩效期望是最强预测因子,应突出 AI 健康助手的实际价值(如健康数据跟踪、个性化建议、慢性病管理);社会影响也有作用,可借助口碑与社交传播。
对政策制定者:感知风险虽影响较弱但仍显著,健康类 AI 产品的隐私保护与安全监管是底线要求。
精读笔记
核心论点:普通用户采纳 AI 健康助手,“有用”(绩效期望)是首要驱动力,但信任是更深层的引擎——它同时提升有用感/易用感、化解风险担忧、并直接促进采纳。
方法要点:
- 扩展 UTAUT(+ 信任 + 风险)在健康 AI 场景验证成立,为后续研究提供可复用框架
- CB-SEM + 完整拟合指标报告,方法严谨
- R² 分解(BI 88.7%)展示了模型的解释强度
局限与边界:
- 样本以 19–39 岁年轻用户为主(80.7%),中老年用户(健康管理主要人群)覆盖不足
- 在线招募,可能存在自选偏差
- 行为意愿 ≠ 实际使用行为,纵向使用数据缺失
可延伸方向:
- 聚焦老年用户群体,比较代际差异
- 加入实际使用行为数据,检验意愿 → 行为的转化
- 结合生成式 AI 大模型助手(如医疗版 GPT),重测模型在新情境下的适用性
原文地址
- DOI:10.1038/s41598-025-01897-0
- 期刊:Scientific Reports(Nature Portfolio),2025 年 5 月
- 图表来源:原文 Figure 1、Figure 2、Table 6、Table 7(开放获取)