ChatGPT 用于文本分析?如何在会计研究中运用生成式大语言模型
论文精读:de Kok(2025)在 Management Science 发表方法学指南,给出 GLLM 文本分析的决策框架与全流程——任务设计、提示词工程、批量处理、人工编码对比验证与构念效度检验,并用 160,049 条数据端到端演示。
文献:de Kok, T. (2025). ChatGPT for Textual Analysis: How to Use Generative LLMs in Accounting Research. Management Science. DOI 10.1287/mnsc.2025.06699。Management Science(INFORMS 出版,管理学与商学公认顶刊),影响因子 4.9(Q1)。
研究问题:会计与管理研究越来越依赖文本证据——年报中的 MD&A 讨论、业绩说明会记录、分析师报告、新闻与社交媒体帖文,承载着结构化财务数据难以捕捉的构念(如管理层语气、信息披露策略、前瞻性表述)。但传统文本分析工具有明显瓶颈:词典法简单透明,却无法处理语境、反讽与长程语义;词袋 + 机器学习需要大量人工标注,且忽略词序与上下文。ChatGPT 等生成式大语言模型(generative large language models,GLLM)的出现,让“用对话的方式让机器读懂文本”成为可能,却也带来新的焦虑:结果可信吗?可复现吗?审稿人会接受吗?论文要回答的正是三个问题:什么时候该用 GLLM、怎么用才规范、怎么证明它真的用对了。
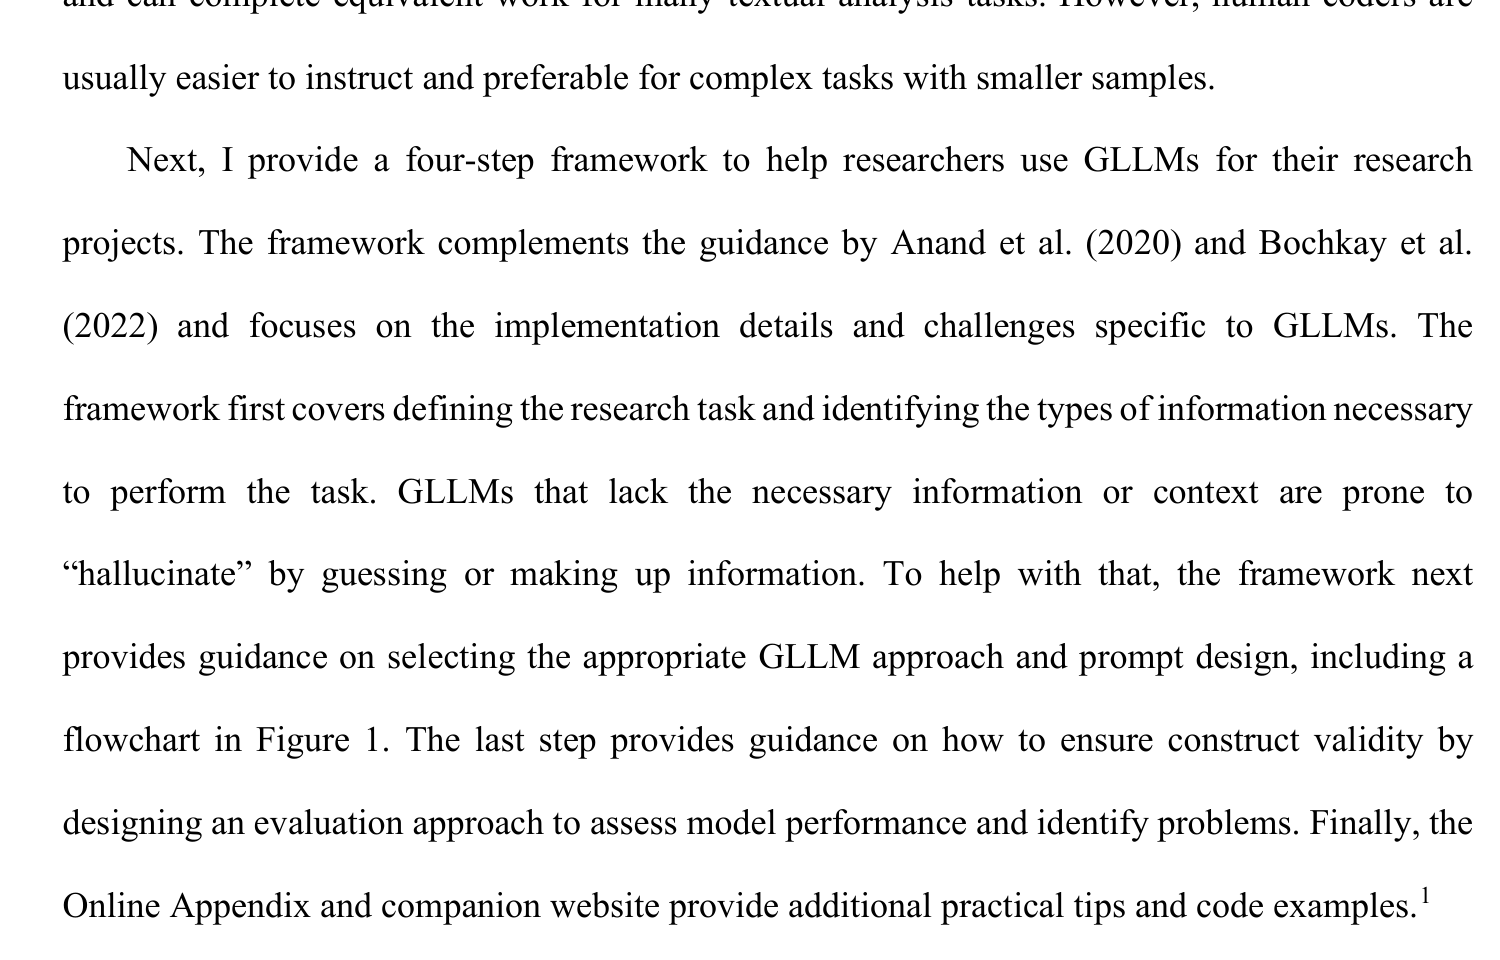
论证思路:这是一篇方法学(methodology)论文——它的贡献不是新的实证发现,而是把“用 GLLM 做文本分析”从零散的个人经验提炼为一套可复制的规范流程。作者先构建方法选择决策框架(原文 Figure 1),帮助研究者在词典法、机器学习与 GLLM 之间做出有依据的选择,并区分零样本、少样本、微调三种 GLLM 用法;随后以包含 160,049 条非答案文本的大规模数据完成端到端演示(原文 Figure 3),逐环节展示任务设计、提示词工程、批量处理、与人工编码对比的质量验证以及构念效度检验。论文由此成为顶刊层面的方法学指南,供会计与管理研究者直接参照执行。
一、决策框架:什么时候用 GLLM,用哪种
原文 Figure 1 回答的不是“GLLM 好不好”,而是“你的任务该不该用它、怎么用”。按框架的逻辑,研究者应依次问自己四个问题:
1. 任务是否真的需要语义理解? 如果目标只是统计关键词是否出现(如“文本中是否提及风险”),词典法即可胜任——透明、便宜、零 API 成本。只有需要理解语境、反讽、隐含语义或生成式输出(总结、改写、结构化抽取)时,才进入机器学习或 GLLM 路线。
2. 有多少人工标注数据? 有大量高质量标注(数千条以上)时,传统监督学习甚至微调模型可能更稳定可控;标注稀缺(几十到几百条)时,GLLM 的少样本能力具有明显优势——这正是许多会计与管理研究场景的常态。
3. 对可复现性与透明度的要求有多高? 词典法是“白箱”,规则一清二楚;GLLM 是概率模型,同一输入多次调用可能给出不同输出。若研究要求严格可复现(档案研究、监管相关议题),需要额外措施(固定模型版本、温度设为 0、多次调用取多数票),并把这一成本纳入决策。
4. 预算约束? 词典法几乎零成本;API 调用按 token 计费,十万级文本的批量处理需要预先估算成本——这也是论文在演示中特别强调批量处理与成本控制的原因。
如果决定使用 GLLM,框架进一步区分三种方式:零样本提示(zero-shot)(直接把任务描述交给模型)、少样本提示(few-shot)(在提示中给出标注示例)、微调(fine-tuning)(用标注数据进一步训练模型)。三者按“所需标注量、成本、任务难度”递增排序——任务越复杂、示例越充足,越靠后。
二、GLLM 文本分析六步流程详解
这是论文方法学价值的核心:一条从原始文本到可发表变量的完整流水线。
第 1 步:任务设计与构念界定
一切从研究构念出发,而不是从“让 ChatGPT 做点什么”出发。研究者需要明确:
- 构念与文本信号:要测的构念(如“管理层语气”)在文本中表现为哪些可观察特征?
- 分析单元:以句子、段落还是整篇文档为单位输出?
- 输出结构:定义标签集合(如 乐观/中性/悲观)、待抽取字段或评分量表,并要求模型以机器可解析的格式(如 JSON)返回,便于输出直接落入数据表。
这一步相当于把“人工编码手册”翻译成模型指令——构念界定不清,后面一切验证都失去意义。
第 2 步:提示词工程
提示词不是随手写的对话,而是研究工具。论文强调一份规范的提示词应包含:
- 角色与任务:明确“你是一名会计文本编码员……”,让模型进入任务语境;
- 构念定义与判断标准:把编码手册中的规则写进提示;
- 示例(few-shot):提供正例、反例与边界案例,示范“什么算、什么不算”;
- 输出约束:固定标签集合、规定输出格式,禁止模型自由发挥;
- 不确定性处理:明确指示“无法判断时输出’无法判断/其他’”,防止模型强行归类——这直接关系到后续验证的诚实性。
提示词应像代码一样版本化:每次修改都记录,因为提示词的微小调整可能显著改变输出分布。
第 3 步:小规模试点与迭代
在投入全量数据之前,先在小样本(如 20–100 条)上运行,人工逐条检查输出:
- 统计错误模式:哪些类别最容易混淆?
- 检查失败案例:是提示词歧义、示例不足,还是任务本身不可判?
- 迭代修改提示词,直到错误模式收敛到可接受水平。
这一“试点—检查—修改”循环是控制质量成本的关键——在 100 条上发现问题,远比在 10 万条跑完之后才发现便宜得多。
第 4 步:批量处理与成本控制
规模化执行阶段,论文强调工程化细节:
- API 批量调用:脚本化处理,设置并发、限流与重试机制;
- 温度参数:为追求可复现性,通常设为 0 或接近 0,降低输出随机性;
- 模型版本固定:记录模型名称与调用日期(如 GPT-4-turbo-2024-xx),因为模型更新会改变行为;
- 成本预算:先在小批量上测算每万条文本的 token 成本,再决定全量规模;
- 数据安全:涉及未公开披露或敏感文本时,注意第三方 API 的数据处理条款。
第 5 步:质量验证——与人工编码对比
这是审稿人最关心的环节,也是论文方法学贡献的重点:
- 从全量数据中抽取验证子样本(最好分层抽样,覆盖不同文本类型与类别),由研究者或领域专家独立人工编码;
- 计算 GLLM 输出与人工编码的一致性:精确率、召回率、F1、Cohen’s kappa 等指标;
- 按类别分层报告误差:哪些类别稳定、哪些类别存在系统性混淆;
- 检验模型自身稳定性:同一输入多次调用(test-retest),报告输出一致性——这是 GLLM 特有、词典法不需要的验证维度。
与人工编码的高一致性是“测量可信”的直接证据,也是论文在演示中反复强调的验收标准。
第 6 步:构念效度检验
一致性证明“机器和人的判断很像”,但还要证明“测到的是想测的东西”:
- 收敛效度:GLLM 测量应与同一构念的已有代理变量(如既有词典测量的语气、文本情绪指标)正相关;
- 判别效度:应与不同构念的测量弱相关;
- 理论预期检验:新测量是否与理论预测的关系模式一致(例如“语气越乐观的公司,未来业绩表现越好”);
- 稳健性:把 GLLM 变量放入主回归模型,检验结论是否对测量方式的选择敏感。
三、演示:160,049 条数据的端到端检验
方法不能只停留在建议层面。论文用包含 160,049 条非答案文本的大规模数据完成了整条流水线的演示(原文 Figure 3),展示方法从“小样本试点”到“十万级全量处理”的可扩展性:
- 六步流程在真实规模上可运行、可验收;
- 与人工编码的对比验证提供了可量化的质量证据;
- 构念效度检验把 GLLM 测量与理论预期联系起来,说明其输出能够进入后续计量分析。
这一演示的意义在于:它把“用 GLLM 做文本分析”从个案经验提升为有规模证据支撑的标准流程——研究者可以直接把论文当作操作手册来用,而不必担心“方法没被验证过”。
四、对管理/会计研究者的研究建议
- 把 GLLM 放进工具谱系,而不是取代一切:词典法适合简单、需要完全透明的任务;GLLM 适合语义复杂、标注稀缺的任务;两者还可以互为稳健性检验;
- 把提示词当作研究资产来报告:在论文方法部分公开模型版本、温度参数与提示词全文(或放入附录),像报告统计模型设定一样报告测量流程;
- 验证先于发表:与人工编码的对比和构念效度检验应成为使用 GLLM 测量的标配,而非可选项;
- 控制成本、匹配规模:先试点、算清 token 预算,再决定全量范围;
- 注意数据合规:涉及保密或敏感文本时,评估第三方模型的数据使用条款。
精读笔记
核心论点:生成式大语言模型可以成为会计与管理研究文本分析的可靠工具,但前提是遵循规范流程——用决策框架选择方法、用六步流水线执行测量、用人工编码对比与构念效度检验证明测量质量。GLLM 的价值不在“替代人工”,而在“把人工编码的智慧规模化”。
方法要点:
- 方法选择决策框架(Figure 1):任务语义复杂度 × 标注数据量 × 可复现性要求 × 成本,共同决定用词典法、机器学习还是 GLLM
- 六步流水线:任务设计 → 提示词工程 → 试点迭代 → 批量处理 → 人工编码对比验证 → 构念效度检验
- 质量验证双轨制:与人工编码的一致性(精确率/召回率/F1/kappa)+ 模型自身稳定性(多次调用一致性)
- 用 160,049 条非答案文本完成端到端演示(Figure 3),证明十万级规模可操作
局限与边界:
- GLLM 输出本质是概率性的,即使温度设为 0 也不能完全保证跨时间、跨模型版本的可复现性
- 提示词依赖研究者判断,不同提示词可能产生不同结果——框架降低但不能消除主观性
- 构念效度检验依赖“存在可比的已有测量或理论预期”,对全新构念的检验能力有限
- API 成本与数据合规(第三方处理条款)可能限制部分研究场景的使用
可延伸方向:
- 把该流程用于中文管理文本(年报、业绩说明会、政策文件)的测量,建立中文语境下的验证证据
- 用 GLLM 做长文档结构化抽取(如把整份年报压缩为结构化信息表),扩展任务类型边界
- 将 GLLM 测量与传统词典测量同时报告,作为稳健性检验的“双测量”标准做法
- 把 GLLM 输出的不确定性本身作为信息加以利用(如置信度与文本模糊性之间的关系)
实践价值
对个人研究者的直接启示:GLLM 文本分析不是“把文本丢给 ChatGPT”,而是一条有验收标准的流水线。照此流程,哪怕面对十万级文本,也能给出审稿人可检验的测量证据;反过来,缺少人工编码对比与构念效度检验的 GLLM 测量,应当被当作“未经验证的测量”来对待。
原文地址
- DOI:10.1287/mnsc.2025.06699
- 期刊:Management Science(INFORMS 出版),2025 年
- 图表来源:原文 Figure 1(GLLM 方法选择决策框架)、Figure 3(160,049 条非答案数据的演示结果)