社会科学研究的自然语言处理:一篇综合性综述
论文精读:Hou 与 Huang(2025)在 Chinese Journal of Sociology 发表——系统评述 NLP 技术如何用于社会科学文本研究,覆盖从文本表示到语义提炼全流程。
文献:Hou, Y., & Huang, J. (2025). Natural language processing for social science research: A comprehensive review. Chinese Journal of Sociology, 11(1). DOI 10.1177/2057150X241306780。SSCI,IF≈2 区间;Asta 引用快照 14(2026-09-04)。
研究问题:社会学、心理学、政治学等学科长期依赖文本资料(问卷开放题、访谈、新闻、政策文本),但非结构化自然语言的数值化处理一直是痛点。论文要回答:NLP 技术能为社会科学研究提供哪些能力?从非结构化文本到可分析的结构化语义,标准流程是什么?研究者应警惕哪些陷阱?
论证思路:技术综述路径——按”从非结构化文本表示到语义信息提炼“的全流程组织内容:先讲文本如何表示为机器可读形式,再讲语义信息如何抽取,覆盖基于专家规则的算法与无监督/有监督机器学习方法,并介绍其在社会学与政治学研究中的典型应用。
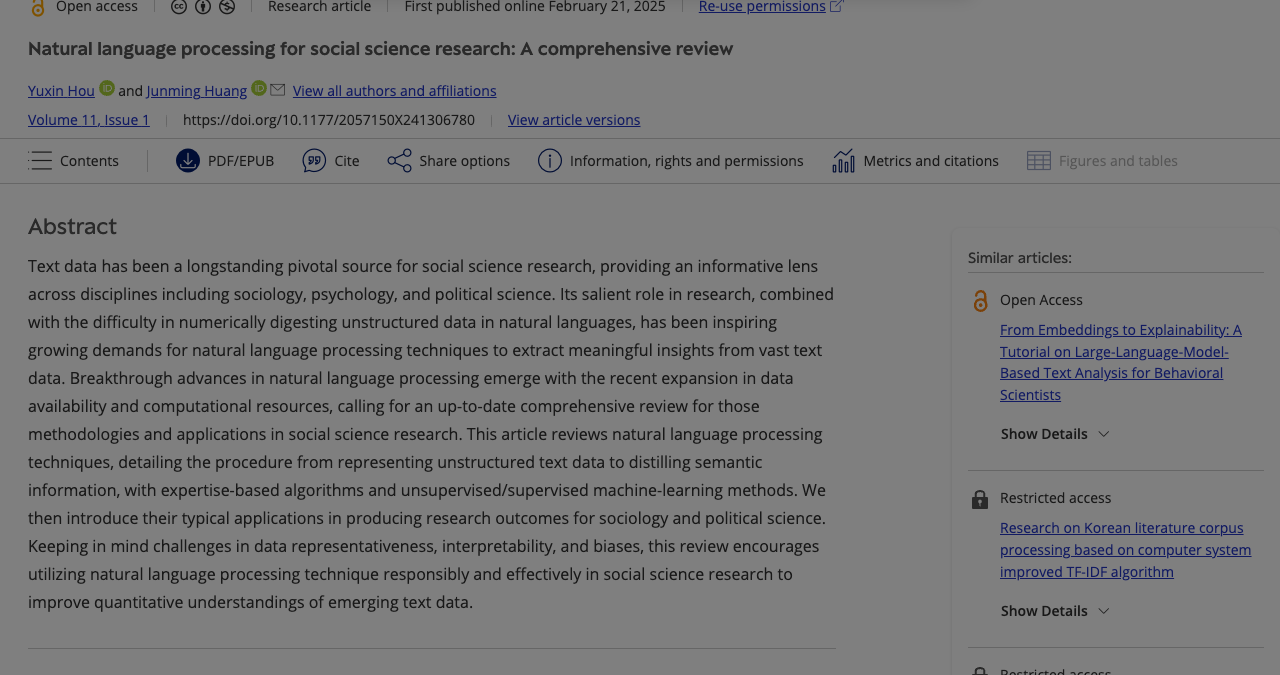
重点提醒(对研究者最有价值的部分):文章强调社会科学语境下 NLP 的三类挑战——数据代表性、可解释性与偏差,倡导负责任且有效地运用 NLP,以提升对新兴文本数据的量化理解。
启示:
- 对人文社科研究者:这是入门“文本即数据”的系统路线图——先想清楚文本代表谁(代表性),再选规则/ML 方法,最后必须做偏差与可解释性审视;
- 对做混合方法的研究者:NLP 编码可辅助但不应替代人工判断,输出需保留人工校验环节;
- 方法论上可与其“AI 素养”研究衔接:同一套“代表性—可解释性—偏差”框架同样适用于 AI 辅助的内容分析。