知识重塑提问:提问能力越强,考试成绩反而越差?
论文精读:Raz & Kenett(2026)用学期纵向数据揭示「评估悖论」——高阶提问能力在开放式项目上是资产,在标准化考试中却成为负债。
文献:Raz, T., & Kenett, Y. N. (2026). Knowledge reshapes inquiry by changing question asking ability and impacting academic assessment. npj Science of Learning, 11, Article s41539-026-00402-0. 2026 年 2 月 17 日发表。
研究问题:提问是人类沟通、认知发展与学习的核心。以往研究多在受控、非纵向情境下考察提问,却很少追问:人们提问的原创性与复杂度如何随时间变化?这种能力如何响应知识习得?提问能力能否预测学业表现? 尤其是——一个学生提问的深度与原创性,在面对不同类型的学业评估时,是否表现迥异?
论证思路:论文提出并检验「评估悖论」——现代教育鼓励创造性探究(发散思维),但标准化考试测试的是收敛性回忆(快速准确提取单一正确答案)。研究在一个学期纵向样本中,同时测量一般提问能力与领域特定提问能力的变化,并对比它们对开放式项目与封闭式考试两类评估的预测作用。
核心概念与理论框架
两种提问能力
研究区分了两种提问能力:
- 一般提问能力(General AQT):对日常物品(如铅笔、袜子)提出创造性问题的能力,反映领域通用的认知灵活性;
- 领域特定提问能力(Domain-Specific DS-AQT):对专业概念(如心理学实验)提出问题的能力,反映语义知识结构的掌握。
一般能力对应「认知灵活性」(flexibility pathway),领域特定能力对应「知识整合」(persistence pathway)。随着学习深入,前者可能衰退,后者应当提升——这一区分挑战了“提问能力是稳定特质”的传统观点。
提问的多阶段过程(QuInS 框架)
论文引用 QuInS 框架(Questions in Information Seeking),指出提问是多阶段认知过程:
- 检测知识缺口(detect gap)
- 产生好奇心(curiosity)
- 形成问题(formulate)
- 评估与精炼(evaluate & refine)
布鲁姆分层与 LLM 自动评级
研究者使用修订版布鲁姆分类法对问题复杂度评级,并用**微调的大语言模型(LLM)**自动判定每个问题所处的布鲁姆层级。例如:
- “什么是神经递质?” → 记忆(Level 1)
- “如何设计实验验证工作记忆容量与创造力的关系?” → 创造(Level 6)
研究方法
样本:68 名修读一学期《心理学导论》课程的本科生。
设计:学期初(Time 1)与学期末(Time 2)分别完成一般与领域特定提问任务,同时完成一项开放式期末项目和一项封闭式选择题考试。
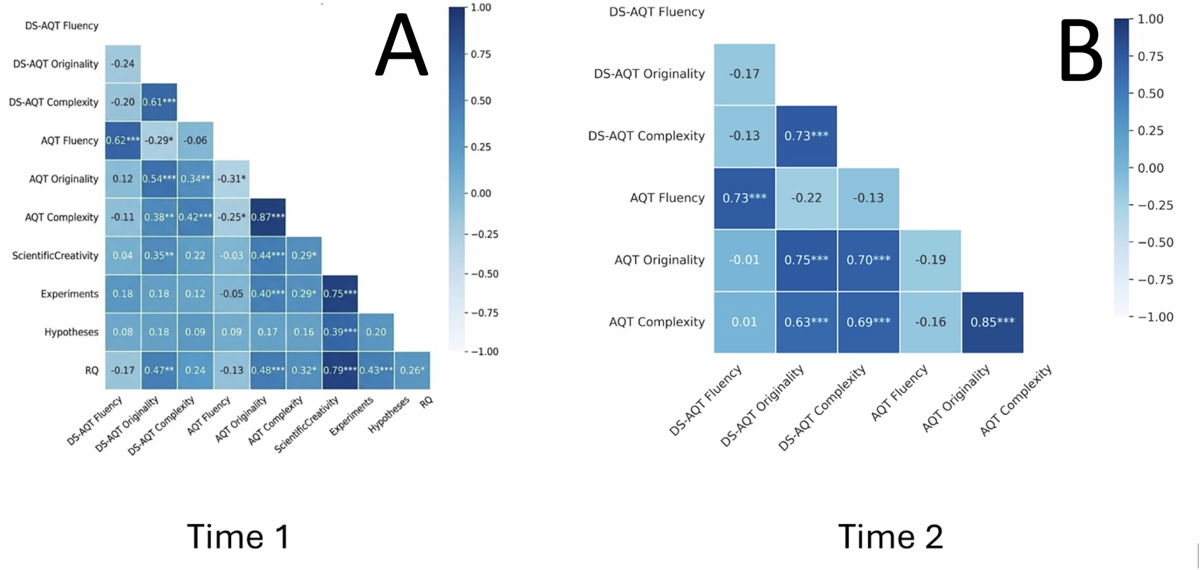
纵向对比:比较两种提问能力在学期内如何随知识积累而变化,并检验其与两类评估表现的关系。
发现一:知识积累重塑提问能力
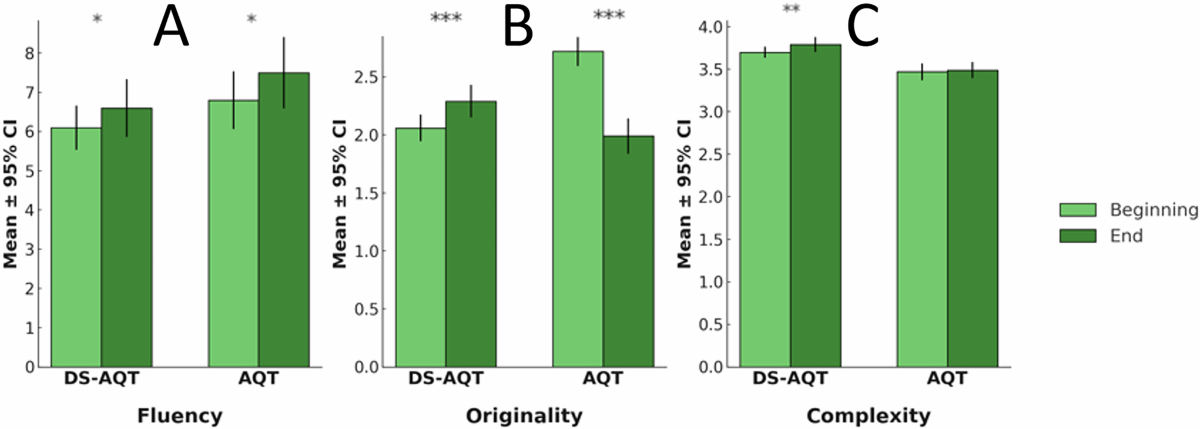
通过对比学期初(Time 1)与学期末(Time 2)的数据,发现分化模式:
- 领域特定提问能力随时间显著提升(DS-AQT fluency 从 M=6.1 增至 M=6.6,且复杂度、原创性同步提升);
- 一般提问能力保持稳定或衰退。
随着专业知识积累,学生的认知资源从泛化探索(对日常物品的天马行空提问)转向领域深耕(基于知识结构的深度提问)。这支持了“提问能力并非稳定特质,而是受知识基础塑造的动态技能”。
发现二:评估类型的「双刃剑」效应
研究在同一纵向样本中证明:同一种提问能力对不同评估类型具有相反的作用:
- 一般与领域特定提问能力与封闭式考试表现呈负相关——高阶提问能力在标准化测试中反而预测更差的成绩;
- 与开放式项目表现呈正相关——同样的能力在创新任务中是资产。
这实证了「评估悖论」:教育系统声称培养批判性思维,却用标准化测试“惩罚”这种思维。用布鲁姆的术语说:我们正在用衡量“理解与记忆”的工具,去测量一群被鼓励进行“评价和创造”的学生。
精读笔记
核心论点:提问能力不是稳定特质,而是随知识增长演化的动态技能;它在不同评估类型下发挥相反作用——开放式评估受益于领域特定复杂度,封闭式考试受损于一般原创性。学生学业表现的差异,可能并非能力不足,而是评估工具设计的认知需求不同(发散 vs 收敛)。
方法要点:
- 学期纵向设计(Time 1 → Time 2)首次追踪了提问能力随知识积累的动态变化
- 一般/领域特定提问能力的分野,把“认知灵活性”与“知识整合”两条通路操作化
- 用微调 LLM 自动做布鲁姆层级评级,为开放性回答提供可扩展的量化方法
局限与边界:
- 样本较小(N=68)且为单一课程(心理学导论),推广需谨慎
- 相关性研究:提问能力与评估表现的负相关不一定是因果(可能有第三变量,如学习风格)
- LLM 自动评级的信度与效度依赖训练数据与评分标准,需与人工评分交叉验证
可延伸方向:
- 不同学科(理工 vs 人文)中,评估悖论是否同样成立?
- 若教育目标是培养高阶思维,评估体系如何超越标准化测量,纳入捕捉生成性学习的开放式评估?
- 教师能否通过“早期广泛探索 → 后期知识整合提问”的分阶段策略,兼顾两种能力的发展?
实践建议(论文原意)
- 提问是可塑技能:教师应根据学习阶段调整探究策略——早期鼓励广泛的探索性好奇,后期引导基于知识的整合性提问;
- 评估体系需反思:如果教育目标是培养创造力和高阶思维,评估必须超越纯粹的标准化测量,纳入更多开放式评估;
- 重新审视公平性:那些在开放式创新中表现卓越、具备复杂探究能力的学生,在传统标准化闭卷测试中可能处于劣势。
原文地址
- DOI:10.1038/s41539-026-00402-0
- 期刊:npj Science of Learning(Nature Portfolio),2026 年 2 月 17 日