迈向 AI 联合科学家:多智能体系统自动提出科学假说(Towards an AI Co-Scientist)
论文精读:Gottweis 等(2025)Google DeepMind 提出 AI 联合科学家系统——基于 Gemini 2.0 的多智能体架构(生成、反思、排序、演化等),自动提出科学假说与研究方案,并在药物重定位、耐药机制、肝纤维化靶点等生物医学难题上产出经实验验证的假设。
文献:Gottweis, J., Weng, W.-H., Daryin, A., Tu, T., et al. (2025). Towards an AI co-scientist. arXiv preprint. DOI 10.48550/arXiv.2502.18864。Google DeepMind 预印本(arXiv:2502.18864),后收录于 Nature(Nature,Q1,预印本阶段发布)。
研究问题:科学发现的起点是“提出一个好问题”——具体而言,是提出新颖、可检验、且经得起同行推敲的假说。然而假说生成恰恰是科研链条中最依赖直觉与偶然性的环节:研究者需要在海量文献、既有数据与领域先验之间建立联想,而人类专家的“灵感瓶颈”常常以周、月甚至年为单位。本文要回答的核心问题是:能否构建一个人工智能系统,让它像一位资深科研同事那样,自主提出科学假说与研究方案,并与人类科学家协同工作? 这里的挑战不只是“让模型生成几句有道理的推测”,而是要让生成物具备三项硬指标——新颖性(不能只是复述已有知识)、可检验性(假说必须指向具体实验)与科学可信度(符合领域逻辑、能被领域专家认真对待)。
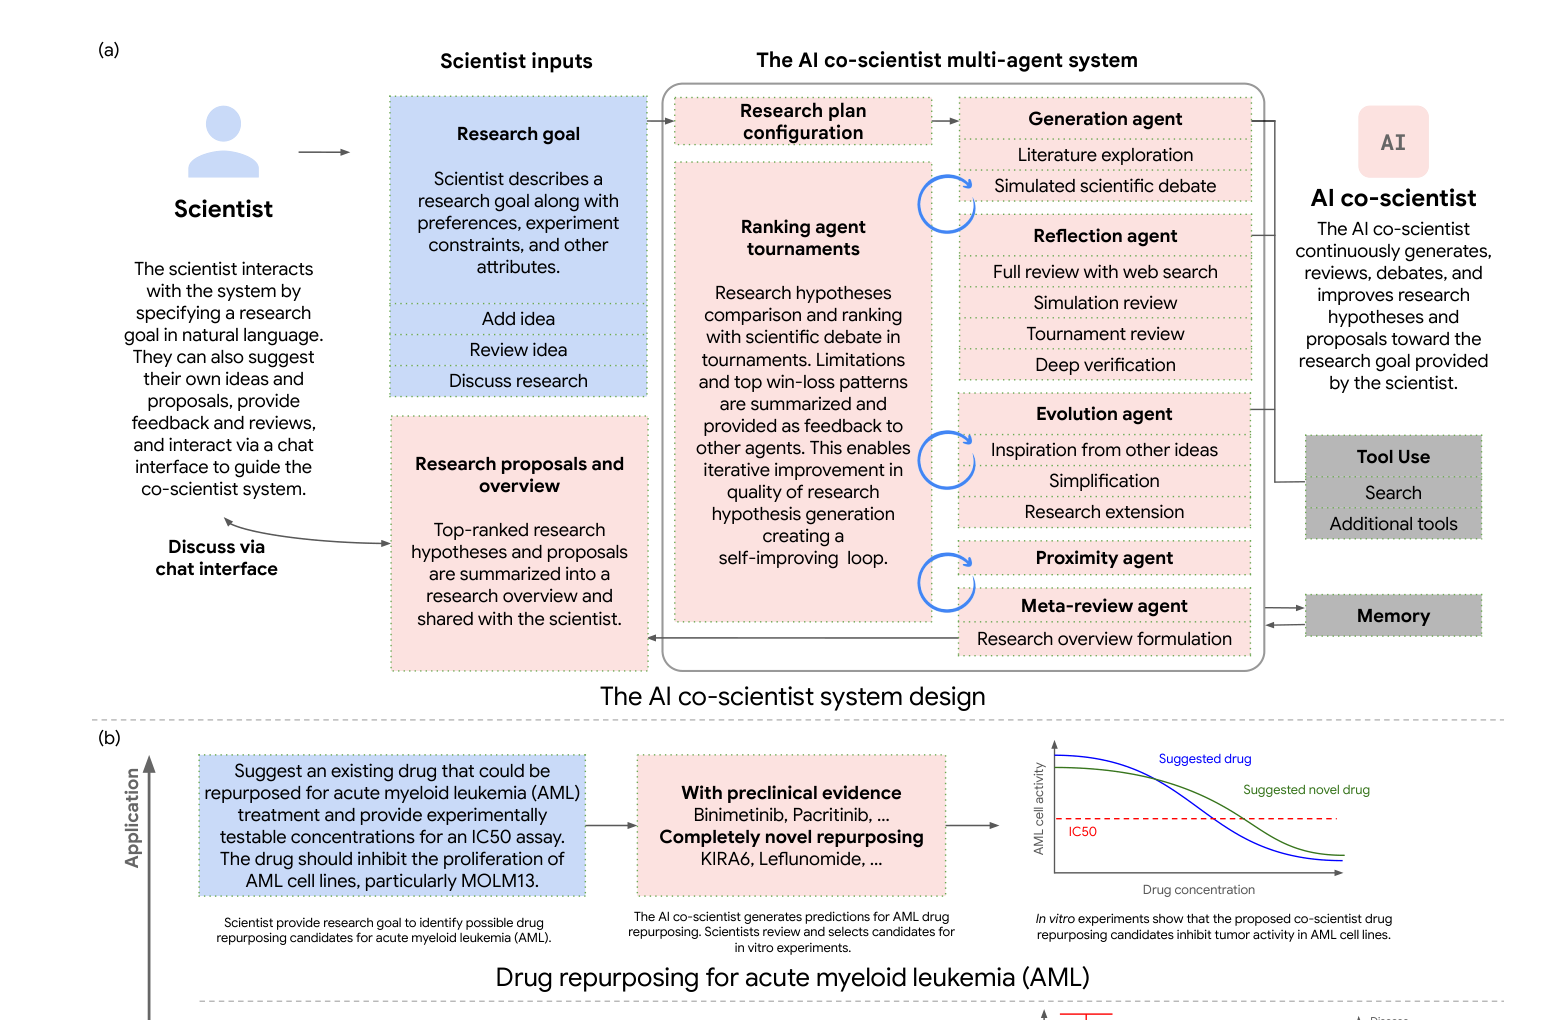
论证思路:论文遵循“系统设计 → 机制分析 → 基准评估 → 真实应用验证”的完整链条。作者首先提出一个以 Gemini 2.0 为基座的多智能体系统:多个分工不同的智能体以”生成—反思—排序—演化“的异步循环协同工作,把”灵感“转化为可评估、可迭代的候选假说;随后通过受控实验揭示测试时计算量(test-time compute)与假说质量之间的标度关系,并构建快速自动化基准(nano 基准)验证系统各组件(如排序器、反思循环)的增量贡献;最后,把系统投向药物重定位、耐药机制解释、新靶点发现等真实的生物医学难题,由湿实验室(in vitro/in vivo)与领域专家共同检验其产出——部分假说获得实验验证。论证的关键设计在于:系统的价值最终不由”看起来聪明“来评判,而由实验证据来裁决(原文 Figure 1 总结了系统架构与验证流程)。
一、系统架构:一组各司其职的“科研智能体”
与“单个大模型直接回答问题”的常规用法不同,AI 联合科学家把科研协作过程拆解为多个可独立调用、异步协作的智能体,每个智能体对应科研流程中的一个认知环节:
- 生成智能体(Generation agent):负责提出初始候选假说与研究方案——它综合研究目标、背景文献与用户提供的实验观察,产出结构化的假说草案;
- 反思智能体(Reflection agent):对候选假说进行批判性审视,模拟“审稿人”与“导师”的双重视角,指出假设漏洞、证据缺口与替代解释,输出改进意见;生成与反思构成“提出—反驳—修正”的内部辩论循环;
- 排序智能体(Ranking agent):通过**锦标赛式自博弈(tournament-style self-play)**对候选假说两两比较、循环淘汰,并以类似 Elo 的评分机制为假说排序——让系统在无人监督打分的情况下形成“质量梯度”;
- 演化智能体(Evolution agent):借鉴遗传算法,对高分假说进行变异(mutation)与重组(recombination),在既有候选的基础上探索邻近的假说空间,维持多样性与持续改进;
- 邻近性智能体(Proximity agent):评估新假说与已有文献/已提交假说的语义距离,把”新颖性“作为可计算指标纳入筛选,防止系统陷入对已知结论的重复表述;
- 元评审智能体(Meta-review agent):汇总上述结果,生成最终的研究方案综述,并给出每项建议的理由与可信度说明;
- 监督智能体(Supervisor agent):统筹全局,决定各智能体的调用顺序与迭代轮次,把分散的产出收敛为可交付的最终结果。
这套架构的要点在于:它把“创造力”工程化为可组合的流水线——生成负责发散,反思负责收敛,排序负责比较,演化负责探索,邻近性负责守“新”,各环节互为制衡,最终输出的不再是一句孤立的猜测,而是一份附有理由链与置信度的研究方案。
二、工作方式:生成—反思—排序—演化的闭环
系统的工作方式可以概括为一个循环推进的异步多智能体协作流程:
1. 输入与任务设定:研究者提供研究目标(如“为某疾病寻找可重定位的药物”“解释某耐药现象背后的机制”)、背景资料与可用的实验数据。系统据此界定问题空间。
2. 生成与反思的迭代:生成智能体产出初始假说;反思智能体以批判视角逐条审阅,生成“反驳—修改”意见;两者循环多轮,使假说在内部辩论中不断被打磨。这一“先提出、再自我挑战”的设计,是系统产出高质量假说的第一道保险。
3. 排序与演化的循环:候选假说进入锦标赛式排序,胜出的高分假说交由演化智能体变异与重组,产生“下一代”候选,再进入下一轮反思与排序。系统重复这一”生成—反思—排序—演化“循环直至收敛,由监督智能体汇总、元评审智能体复核后交付。
4. 测试时计算的标度效应:论文的一个重要机制发现是,假说质量随测试时推理计算量的增加而显著提升(呈近似幂律的标度关系)——投入更多计算,系统会进行更多轮生成—反思与更充分的锦标赛比较,产出更优。这与大模型领域“更多计算换更好结果”的规律一致,也说明该系统并非“碰运气式”的随机发散,而是可预测地“越算越好”。
5. 评估体系:为在开发中快速迭代,作者构建了面向 15 个生物医学任务的评估集,并设计了自动化快速基准(nano 基准,用领域专家与 LLM 评审员对假说质量打分),验证了排序器与反思循环的增量价值——消融实验显示,去掉反思或排序组件,产出质量明显下降,证明各智能体各有不可替代的贡献。
三、验证案例:从自动生成的假说到实验证据
论文最具说服力的部分,是把系统投向真实、未解的生物医学难题,并接受湿实验室的检验(见原文 Figure 1 的验证流程)。三个代表性案例:
案例一:药物重定位——baricitinib 治疗急性髓系白血病(AML)。系统在药物重定位任务中提出,baricitinib(一种已获批用于类风湿关节炎等适应症的 JAK 抑制剂)可能作为急性髓系白血病的候选治疗药物。这一假说随后在**体外(患者来源细胞)与体内(小鼠模型)**实验中获得验证:baricitinib 展现出抑制白血病细胞增殖、减轻疾病负担的活性。该案例展示了系统的实用潜力——在已有药物库中“老药新用”,绕过漫长的新药研发周期。
案例二:耐药机制——为“观察到却解释不了”的实验现象给出机制假说。科研中常见的情形是实验数据与既有理论冲突:系统被要求解释一个此前缺乏机制解释的耐药现象,它提出的假说指向一条此前未被考虑的调控通路,且其关键预测获得了后续实验验证。这一案例体现了系统“从异常数据到机制假说”的能力——这正是假说生成最考验创造性、也最难以规模化的环节。
案例三:新靶点发现——肝纤维化的潜在治疗靶点。在靶点发现任务中,系统基于疾病背景与文献证据提出新的潜在干预靶点,并在相关模型与人体组织样本中获得验证,为肝纤维化这一缺乏有效药物的疾病提供了新的研究方向。
需要强调的是,作者对验证保持审慎:被选入实验验证的只是排序靠前的少数假说,多数候选并未走向实验台。因此这些案例的意义不在于“AI 假说全部正确”,而在于证明该系统能在合理成本内产出足够多的高质量候选,使其中一部分经受住实验检验——这正是科研协作者应有的产出形态。
四、科研启示:AI 作为科研协作者的工作流与伦理影响
对科研工作流的影响:
- 假说生成从“灵感事件”变为“可调度流程”:系统把最不确定的创造环节转化为可并行、可迭代的自动化过程,研究者可以快速获得大量候选假说,把精力转移到筛选、判断与实验设计上;
- 研究方案的系统化起草:系统产出不仅包含假说本身,还附带实验设计、验证路径与置信度说明,相当于“把想法做到可执行”;
- 人机协作的分工重置:论文勾勒的范式是”AI 提供候选,人做裁决“——AI 负责发散与穷举,人类专家负责甄别、语境化与最终拍板。这与”AI 取代科学家“的想象截然不同,更接近”AI 扩大科学家的带宽”;
- 对科研组织的启示:此类系统可嵌入课题组的日常流程——晨会前由 AI 备好若干候选方向、审稿前由反思智能体预演评审意见、写作时由系统补齐文献支撑——把协作深度从“工具”推进到“同事”。
对科研伦理的影响:
- 选择偏差与验证偏差:被实验验证的只是系统产出的少数高分假说,若系统在排序环节系统性偏好某一类假说(如更“主流”、更易验证的方向),会导致探索空间被人为收窄,且这种偏差难以从最终成功案例中察觉;
- 署名、披露与责任:AI 实质性参与假说生成后,“作者贡献”与“方法披露”如何界定?实验失败的责任如何归属?期刊与基金评审需要为新形态的协作建立透明规则;
- 可验证性的底线:系统输出的任何假说都必须以“可检验”为前提,且验证结果应回流更新系统——否则自动化生成会放大未经检验的“表面合理”;
- 加速的双刃剑:假说生成提速同样适用于高风险研究领域(如新型病原体、生物武器相关),科研治理需要同步跟上自动化带来的速度变化;
- 依赖与批判性退化:若研究者习惯性地接受系统候选、放弃独立质疑,批判性思维可能被“流水线效率”侵蚀——人机协作的边界必须由人来守住。
精读笔记
核心论点:科学发现中的“假说生成”环节可以系统化、自动化。Google DeepMind 提出的 AI 联合科学家以“生成—反思—排序—演化”的多智能体闭环,把创造性思考工程化为可扩展的计算流程,并在药物重定位、耐药机制解释与新靶点发现等真实生物医学难题上产出经实验验证的假说。其意义不在于“AI 取代科学家”,而在于证明一种新范式——AI 作为科研协作者,负责大规模发散与候选生成,人类科学家负责判断与裁决,从而成倍拓宽科研探索的带宽。
方法要点:
- 多智能体架构:生成、反思、排序、演化、邻近性、元评审、监督七个智能体分工协作,基于 Gemini 2.0 构建
- 核心闭环:“生成—反思”内部辩论 + “锦标赛式 Elo 排序” + “变异/重组演化” + “语义邻近性新颖性筛选”
- 测试时计算标度:假说质量随推理计算量近似幂律提升,系统“越算越好”
- 自动化评估:15 个生物医学任务 + nano 快速基准 + 消融实验,验证反思与排序组件的增量价值
- 真实应用验证:baricitinib 重定位治疗 AML(体外与体内验证)、耐药机制假说(实验验证)、肝纤维化新靶点(模型与组织样本验证)
局限与边界:
- 实验验证只覆盖少数高分候选,系统整体假说命中率尚未系统量化;未被选中的假说中可能同样存在有价值但被排序器低估的“长尾”
- “新颖性”依赖语义距离近似,未必等于真正的科学创新——重新表述已有结论与提出范式级突破之间的界限仍模糊
- 评估依赖领域专家与 LLM 评审员的主观打分,评审标准的一致性、领域覆盖度影响结论稳健性
- 当前验证集中于生物医学,其方法向物理、化学、社会科学等异质学科的迁移性有待检验
- 系统产出为“研究方案”而非“已验证结论”,从假说到证据仍依赖完整湿实验周期,论文无法回答“实验资源有限时如何最优分配”
可延伸方向:
- 把闭环从“假说生成”扩展到“实验设计—结果回流—假说修正”的完整闭环,让验证结果自动更新系统先验
- 将排序器的单一质量标尺扩展为多维评估(新颖性、可行性、风险、成本、伦理约束),支持研究者按偏好配置
- 与自动化实验平台结合,形成“AI 提假设—机器人做实验—结果反馈”的自主科研流水线
- 将方法迁移到药物研发之外的高价值场景(材料设计、气候科学、社会科学理论生成)
- 建立“AI 参与科研”的披露、署名与验证规范,为期刊与基金评审提供可操作的制度模板
原文地址
- DOI:10.48550/arXiv.2502.18864(arXiv 预印本,后收录于 Nature)
- 期刊:arXiv preprint(Google DeepMind),2025 年;Nature(Q1)收录
- 图表来源:原文 Figure 1(AI 联合科学家系统设计与实验验证总结)