贝叶斯教学使大型语言模型具备概率推理能力
论文精读:Kim 等(2026,Nature Communications)发现现成 LLM 在贝叶斯信念更新上远逊于规范模型,而用「贝叶斯教学」让 LLM 模仿贝叶斯助手的多轮交互,可显著提升其概率推理能力并泛化到新任务。
文献:Kim, S., et al. (2026). Bayesian teaching enables probabilistic reasoning in large language models. Nature Communications, 17, Article 1238. DOI 10.1038/s41467-025-67998-6。期刊 IF 15.7(JCR Q1)。
研究问题:大型语言模型(LLM)正越来越多地被用作与用户、与世界交互的智能体——做个性化推荐、充当预订助手等。这类任务要求模型在多次交互中不断形成并更新关于用户偏好的概率信念。论文要回答两个问题:① 现成的 LLM 是否真的像贝叶斯智能体那样,随新信息到来而正确地更新信念?② 如果做不到,能否通过“教”——而不是重新设计模型——让它们学会概率推理?
论证思路:以贝叶斯推断为规范标准(normative standard),先在一个可控的航班推荐任务中精确计算“贝叶斯助手”(Bayesian Assistant)的最优信念更新行为,测出现成 LLM 与之的差距;再提出贝叶斯教学(Bayesian teaching)——用“用户与贝叶斯助手”的交互示例教 LLM 模仿贝叶斯助手的预测;最后检验所学技能能否泛化到酒店推荐、网页购物等新任务,并与直接给出正确答案的“神谕教师”(oracle teacher)对照,揭示何种教学信号最有效。
一、贝叶斯教学:把“教”变成选择最优示例
“贝叶斯教学”源自认知科学与机器教学(machine teaching)研究:教师并不简单地堆砌数据,而是选择能让学习者最快逼近目标概念的示例——教什么、以什么顺序教,比教多少更重要。
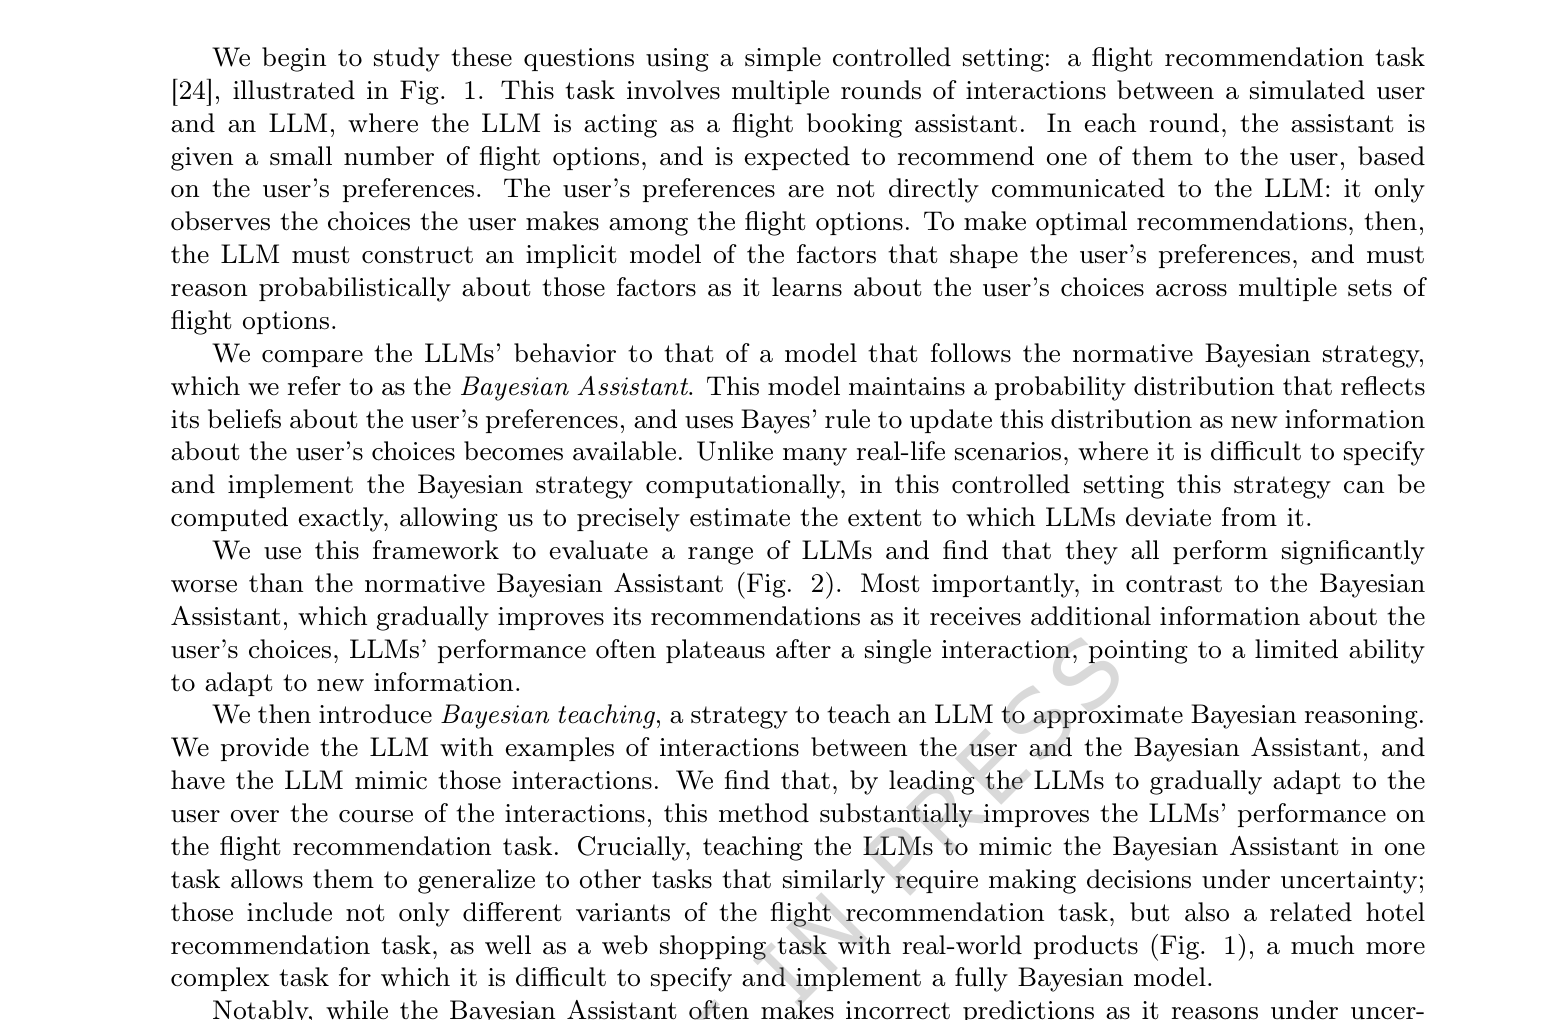
本文把这一思想迁移到 LLM:把贝叶斯助手当作“教师”,它根据贝叶斯规则维护用户偏好的概率分布并逐轮更新;把 LLM 当作“学习者”,用“用户 × 贝叶斯助手”的多轮交互作为教学示例,让 LLM 模仿贝叶斯助手的推荐行为,从而学到“如何随新证据更新信念”这一推理技能,而非记住某个具体答案。
最反直觉的发现是:贝叶斯助手在早期交互中常常做出错误的预测(因为它必须在不确定性下“猜测”),但它的“educated guesses”却是比正确答案更强的学习信号——直接教 LLM 用户真实选择(oracle teacher)的教学效果反而更差。换言之,规范模型的推理轨迹本身,就是最好的教材。
二、方法:多轮交互任务设计
实验在航班推荐任务中展开(图1左):LLM 扮演订票助手,每轮从三个航班选项中向模拟用户推荐一个,随后看到用户实际选择了哪一项——但用户的偏好(由隐藏的奖励函数刻画)并不直接可见,助手只能从用户的选择行为中反推。研究设置了 624 个模拟用户、每段交互 5 轮,让任务足够难到能区分“真更新”与“假更新”。
对照体系有三层:
- 贝叶斯助手(规范标准):精确维护用户偏好分布、用贝叶斯规则更新的最优模型——在此可控场景中可以精确计算,从而量化 LLM 与规范策略的偏离程度;
- 现成 LLM(基线):多家族、开箱即用的 LLM,仅靠上下文与用户交互;
- 人类被试:作为人类推理的参照(在 624 个模拟用户中的 48 个上评估)。
评估指标是第 1 轮与最后一轮(第 5 轮)的推荐准确率,观察模型随信息积累的改善幅度。
三、核心发现:LLM 不更新信念,但可以被教会
发现一:现成 LLM 远逊于贝叶斯助手,且信念更新近乎停滞。 所有被考察的 LLM 表现都显著差于贝叶斯助手;更重要的是,贝叶斯助手会随轮次逐步改善推荐,而 LLM 的性能往往在单次交互后就进入平台期(图2)——它们缺乏“用新信息更新旧信念”的能力,而这恰恰是交互式智能体的核心能力。
发现二:人类也会偏离规范标准。 人类被试的改善幅度大于多数 LLM,但仍然达不到贝叶斯助手的准确率——说明“概率上正确地更新信念”对人类也是难的,这为“教 LLM”提供了认知科学上的对照基线。
发现三:贝叶斯教学显著提升 LLM 的概率推理。 让 LLM 模仿贝叶斯助手的交互后,其在航班推荐任务上的表现大幅提升,并能在多轮中逐渐适应特定用户。
发现四:技能可泛化到新任务。 只在一个任务上教,学到的能力却迁移到了:航班推荐的其他变体、酒店推荐任务,以及真实商品的网页购物任务——后者复杂到难以完整实现贝叶斯模型,恰恰是贝叶斯教学最有价值的应用场景。
四、意义:教 LLM“思考概率”
- 为 LLM 概率推理提供轻量新路径:不依赖手工实现复杂贝叶斯模型,通过“模仿规范模型的推理”即可让 LLM 具备可迁移的概率推理技能,使其可用于信息逐步到达的交互场景;
- 对 AI 教育(教模型推理)的启示:教学示例的选择与顺序比示例数量更关键;“让学生模仿专家在不确定性下的思考过程”,可能比直接告诉正确答案更能培养推理能力——这一结论与人类教学研究高度呼应;
- 发表在高影响力期刊:Nature Communications(IF 15.7,Q1),开放获取,25k+ 次访问,体现了“LLM 能力评估 + 认知科学规范标准”这一交叉路线的高关注度。
精读笔记
核心论点:现成 LLM 无法像贝叶斯智能体那样随新信息更新信念(性能在单轮后即停滞),但通过“贝叶斯教学”——让 LLM 模仿贝叶斯助手在不确定性下的多轮交互——可以显著教会它们概率推理,且该技能可泛化到新的决策任务;规范模型“有错的猜测”是比正确答案更强的教学信号。
方法要点:
- 用可精确计算的贝叶斯助手作为规范标准,量化 LLM 与最优信念更新的差距
- 多轮交互任务(航班推荐,624 个模拟用户、5 轮)使“是否真更新信念”可观测、可区分
- 三层对照:现成 LLM、贝叶斯助手、人类被试;教学条件对照:贝叶斯助手 vs oracle 教师
- 泛化检验:任务变体 + 酒店推荐 + 真实商品网页购物,覆盖“难以实现完整贝叶斯模型”的复杂场景
局限与边界:
- 结论基于航班推荐等受控任务,任务结构(三选一、隐藏奖励函数)相对简单
- 教学通过微调(模仿交互示例)实现,成本与数据需求高于纯提示词方法
- 泛化到“复杂应用”仍需更多证据;网页购物任务虽复杂,但评估仍以推荐准确率为准
- 贝叶斯助手在真实场景中往往无法精确实现,规范标准的可计算性是该方法的前提条件
可延伸方向:
- 将贝叶斯教学扩展到更复杂、更开放的多轮决策场景(医疗、教育、科研助手)
- 研究教学示例的顺序与难度曲线,寻找比“模仿贝叶斯助手”更优的课程设计
- 结合不确定性校准评估,检验学到的概率推理是否伴随可靠的置信度
- 将“规范模型作教师”的思想推广到其他规范理论(如博弈论最优策略、决策论)
原文地址
- DOI:10.1038/s41467-025-67998-6
- 期刊:Nature Communications, 2026, 17, Article 1238(开放获取)
- 图表来源:原文 Figure 1(贝叶斯教学任务:模拟用户与模型的交互)、Figure 2(LLM 与贝叶斯助手、人类被试的多轮表现对比)