用检索增强语言模型综合科学文献(OpenScholar)
论文精读:Li 等(2026)在 Nature 发表 OpenScholar——面向科学文献综合的检索增强语言模型(RAG)系统,配套 ScholarQABench 基准;相比通用大模型,文献综述与问答更准确、引用更可靠。
文献:Li, A., et al. (2026). Synthesizing scientific literature with retrieval-augmented language models. Nature, 650, Article s41586-025-10072-4. DOI 10.1038/s41586-025-10072-4。Nature(Springer Nature 出版,国际公认综合科学顶刊),影响因子 48.5(Q1)。
研究问题:科研人员最耗时、也最依赖专业能力的工作之一,是从海量论文中综合出可靠结论——无论是写文献综述、回答“某方法的最新进展是什么”,还是评估“现有证据是否支持某个结论”。通用大语言模型(LLM)虽然能流畅生成类似综述的文本,却有两个致命问题:其一,模型依赖训练时截断的知识,无法覆盖最新发表的论文,容易“过时”;其二,模型倾向于“编造”参考文献,生成的引用经常张冠李戴甚至根本不存在——这在以严谨著称的科学文献综合场景中是不可接受的。论文要回答的核心问题是:能否构建一个系统,让大语言模型基于实时检索到的真实论文来回答问题、撰写综述,并给出可核验的引用?
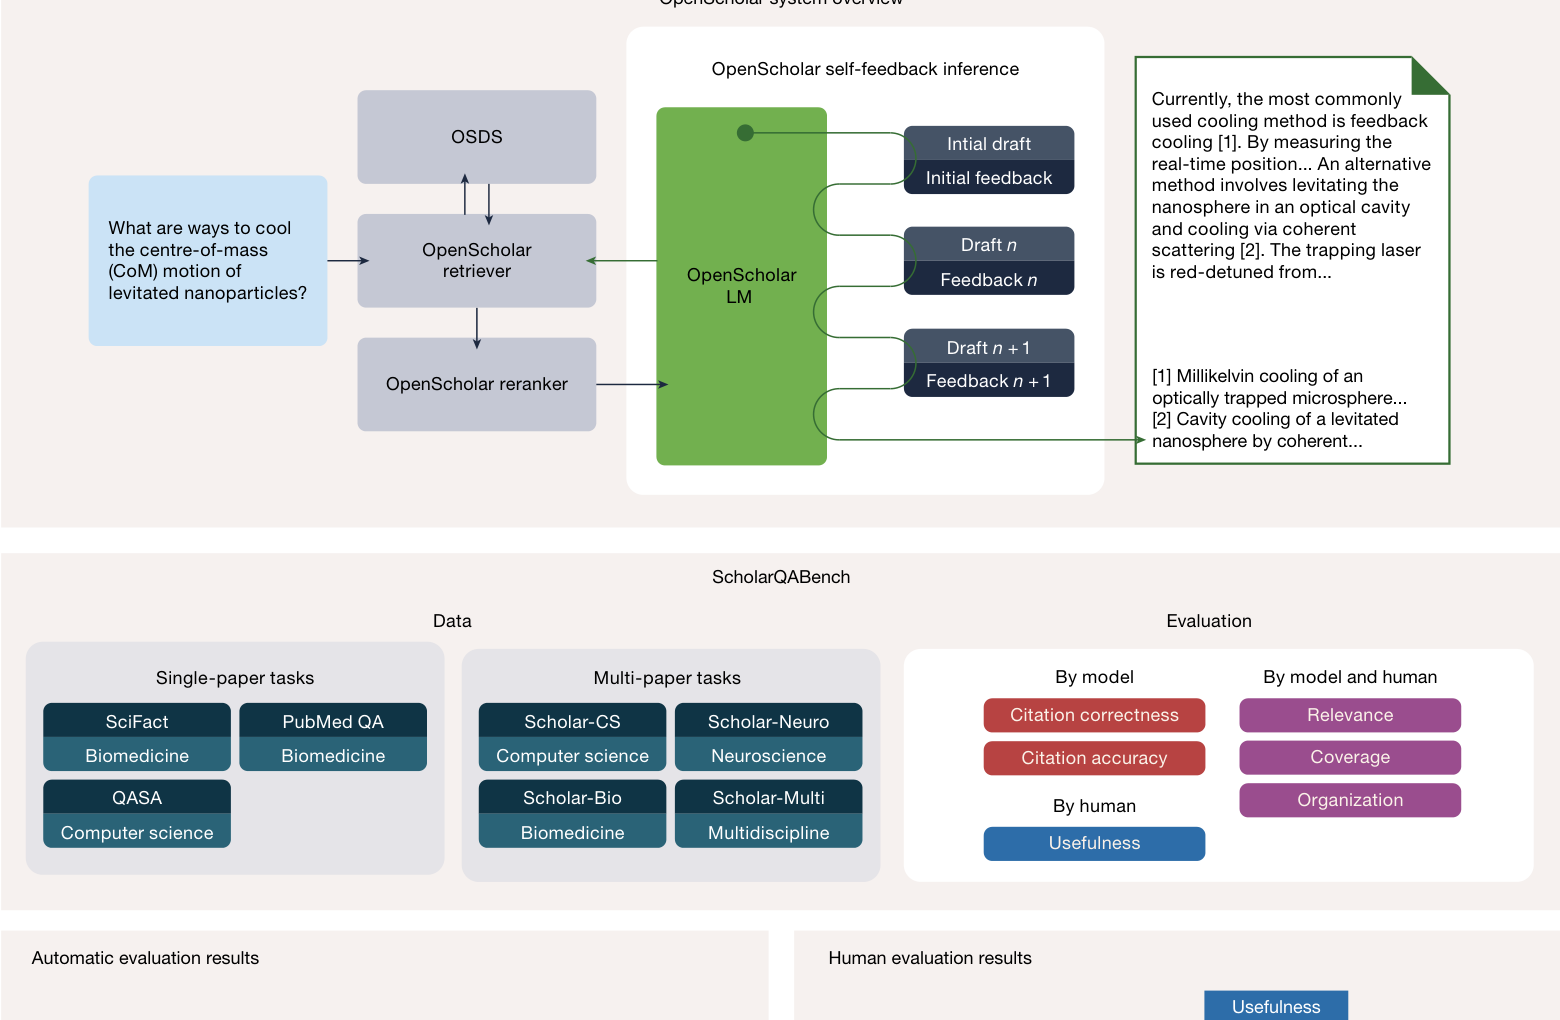
论证思路:论文提出 OpenScholar——一个专门面向科学文献综合的检索增强语言模型(Retrieval-Augmented Generation,RAG)系统。它的基本设计是“先检索、后生成、再标注”:针对研究者提出的问题,系统先从包含 50 万+ 篇论文的大型语料(基于 Semantic Scholar 等学术数据构建)中检索最相关的文献,再把检索到的论文片段作为上下文交给大语言模型生成综述性回答,并让模型在回答中标注每个论断对应的文献来源。为了验证系统有效性,作者构建了 ScholarQABench 基准(原文 Figure 1)——一组覆盖计算机科学、生物医学、物理等领域的文献综合任务与人工参考答案。评估显示:相比通用 LLM 及现有检索增强方案,OpenScholar 在答案准确性、引用可靠性等指标上全面领先。论证链条是“系统设计 → 基准构建 → 对照评估 → 应用展示”的标准工程科学路径。
一、RAG 架构:为什么“生成前先检索”是文献综合的关键
检索增强生成(RAG)的核心思想朴素而有力:让模型不再从“记忆”里找答案,而是从“资料库”里找答案。文献综合任务对 RAG 的依赖尤其明显:
- 知识时效性:科学文献以每周数千篇的速度增长,训练截止日期前的 LLM 无法知道最新成果。RAG 通过实时检索把最新论文纳入上下文,天然解决了“过时”问题;
- 可溯源性与事实约束:检索到的论文片段是“真实证据”,模型被要求基于这些片段作答,幻觉空间被大幅压缩;每个论断都能回溯到具体文献,这是科学写作的底线要求;
- 领域覆盖:单一模型难以精通所有学科,而检索系统可以在问答时动态切换到对应领域的文献子集。
OpenScholar 在这一通用架构上的关键改进在于把“检索”本身做成一个可学习的组件:它不再只用关键词或向量相似度粗筛,而是用检索器迭代收集相关论文,并由评分器(reranker)对候选论文与问题的相关性精细打分排序,确保进入生成阶段的是真正相关、可信的文献。检索质量直接决定综合质量——引用错了来源,再流畅的综述也是误导。
二、OpenScholar 系统:检索、生成与引用的完整流水线
OpenScholar 是一个端到端的系统,其工作流程大致分为三个阶段:
1. 检索与重排序:系统接收研究问题后,从 50 万+ 篇论文的语料中召回候选文献,随后通过相关性评分器精排,选出与问题最相关的若干篇论文。语料基于 Semantic Scholar 等开放学术数据库构建,覆盖最新发表的研究,保证知识的新鲜度。
2. 片段级证据收集:仅仅找到“相关论文”还不够——一篇论文可能长达数十页,与问题相关的往往只有几段。系统进一步在入选论文内部定位与问题直接相关的片段(passage),形成精炼的证据集,避免把整篇论文塞进上下文。
3. 生成与引用标注:大语言模型基于证据集生成综合回答。论文的关键设计是强制引用:模型不仅要回答问题,还要在关键论断后标注支撑文献,且引用必须对应证据集中真实存在的论文与片段——这从机制上杜绝了“编造参考文献”。回答还可以生成带引用的综述文本、要点列表甚至对比表格,直接面向文献综述写作场景。
相比“裸奔”的通用 LLM(仅凭参数记忆作答、引用靠编造),OpenScholar 的全流程都锚定在真实文献之上:检索提供素材,证据集限定事实边界,引用标注保证可核验。这正是它在文献综合任务上更准确、引用更可靠的结构性原因。
三、ScholarQABench 基准与评估结果
再好的系统也需要可复现的检验。论文构建了 ScholarQABench(原文 Figure 1)——专为“科学文献综合”设计的评估基准,包含多个子任务类型:
- 文献综合问答:提出需要跨多篇论文综合才能回答的问题(如“关于某靶点的药物发现研究进展如何”),对照领域专家撰写的高质量参考答案打分;
- 综述生成:要求系统围绕给定主题生成带引用的综述段落;
- 引用质量评估:单独检验回答中每条引用的真实性、相关性与支撑充分性——这是以往基准普遍忽视、而文献综合最关键的维度。
评估发现(原文 Figure 1 的评估结果部分):
- 准确性领先:在 ScholarQABench 上,OpenScholar 生成的回答显著优于通用 LLM(如 GPT 系列)与通用检索增强基线,尤其在需要多文献综合与领域专业知识的任务上差距明显;
- 引用可靠:OpenScholar 的引用真实性远超通用 LLM——后者生成的参考文献常常是“幻觉”,前者则全部锚定在检索到的真实论文上;即使与人类专家撰写的内容相比,其引用相关性与覆盖度也具备竞争力;
- 泛化能力:系统在不同学科(计算机科学、生物医学等)与不同任务类型上表现稳定,说明“检索—生成—引用”的架构并非只对单一领域有效。
四、科研应用启示:对文献综述与研究助手工具的影响
OpenScholar 的价值不止于一篇论文,它指向科研工具链的一次结构性升级:
- 文献综述的半自动化:综述写作最耗时的是“穷尽文献 + 保证引用准确”。OpenScholar 类系统能把“检索—筛选—综合—标注引用”压缩为分钟级流程,研究者可以把精力从检索整理转移到判断与批判上——综述初稿(draft)由系统完成,把关与深化仍由人完成;
- 研究助手(research assistant)的范式转变:新一代科研助手不应是“聊天机器人”,而应是“带文献库的检索增强系统”——用户提问时实时检索、作答时强制引用、结论可回溯到原文。这使 AI 助手从“可能犯错的信息源”变为“可核验的文献工作台”;
- 引用规范的可工程化:OpenScholar 证明“引用可靠性”不是模型微调就能解决的玄学问题,而是可以通过架构设计(证据集约束 + 强制标注)系统性保证的工程指标——这为学术写作工具、投稿前文献核查工具提供了直接可复用的思路;
- 评估基准的示范意义:ScholarQABench 把“引用质量”纳入评测维度,提醒所有大模型评估者:在知识密集型任务上,答案再流畅,引用不可核验就等于失败。未来的科研 AI 评测应默认包含溯源指标。
精读笔记
核心论点:面向科学文献综合,检索增强架构是比“参数记忆”更可靠的范式。OpenScholar 以“实时检索 50 万+ 论文 → 证据片段约束 → 强制引用标注”的完整流水线,在答案准确性与引用可靠性上显著超越通用 LLM,证明**“先检索、后生成、可溯源”应成为科研 AI 的默认设计**。
方法要点:
- 检索增强生成(RAG)架构:检索器召回 + 重排序器精排 + 片段级证据收集 + 基于证据的生成
- 50 万+ 篇论文语料(基于 Semantic Scholar 等学术数据),保证知识时效性
- 强制引用机制:回答中每个论断标注真实存在的文献来源,从机制上杜绝幻觉引用
- ScholarQABench 基准(原文 Figure 1):覆盖文献综合问答、综述生成、引用质量评估三个维度,其中引用质量是区别于传统基准的关键设计
- 评估体系:与通用 LLM、通用 RAG 基线、人类专家多维对照
局限与边界:
- 综合质量受限于检索质量:如果语料缺失、检索漏检关键论文,系统会“自信地不完整”——错误的边界从“编造”变成“遗漏”
- 引用可靠不等于结论正确:模型可能引用真实论文,但对论文内容的理解与综合仍有偏差
- 语料以英文、已发表论文为主,预印本、非英语文献与灰色文献的覆盖有限
- 依赖开放学术数据库(如 Semantic Scholar)的数据质量与版权可用性
可延伸方向:
- 把 OpenScholar 范式迁移到中文文献、预印本与多语种语料的综合场景
- 在“引用标注”之上增加“论断—证据对齐”的细粒度校验(逐句判断引用是否真正支撑该论断)
- 与论文写作工具结合:自动生成综述草稿并输出可直接导入文献管理软件的引用记录
- 将 ScholarQABench 式“引用质量”指标引入科研 AI 助手评测体系
原文地址
- DOI:10.1038/s41586-025-10072-4
- 期刊:Nature(Springer Nature 出版),2026 年,影响因子 48.5(Q1)
- 图表来源:原文 Figure 1(OpenScholar、ScholarQABench 与评估结果概览)