每日文摘 · 2026-08-19
ChatGPT 青少年版、Agent 安全、中国 AI 双循环、AI 购物入口、负责任科研——今日 5 条高价值信息。
- ChatGPT 推出青少年版,AI 教育产品从通用工具转向年龄分层;
- OpenAI 因 Agent 安全风险暂停部分工作,Agentic AI 风险进入现实测试阶段;
- 中国的 AI 竞争优势可能不仅来自模型,也来自“数据资产化”与产业部署,数据正成为 AI 竞争的新基础设施;
- 41% 的美国消费者已使用生成式 AI 辅助在线购物,搜索入口正从搜索引擎迁移到 AI 助手;
- 新研究提出“Responsible Research with AI”:科研效率提高,不等于科学创新提高。
这三条(1、3、4)都可以直接转化为教育技术或电商研究问题。
1.OpenAI 推出 ChatGPT for Teens:AI 教育开始进入“年龄适配”阶段
图片来源:Associated Press 报道页面。
发布日期:2026年8月18日|来源:Associated Press
摘要
OpenAI 推出面向 13—17 岁用户的 ChatGPT for Teens。与普通版本相比,它强化了自伤、性与情感依赖等内容限制,并针对作业和学习场景调整回答机制,强调引导学生自行形成答案,而不是直接生成作业或论文。家长可以设置“安静时段”,并在有限的高风险情形下接收安全提醒。
报道同时指出,外部儿童权益专家仍担忧长期记忆等机制默认保护不足,现有安全措施的实际效果仍需独立评估。这意味着“年龄适配”不应只理解为内容过滤,还包括认知发展、情感依赖、隐私和家长干预边界。
研究与教学价值
这次产品更新的意义大于一次普通功能发布。AI 教育可能正在从“所有学生使用同一种大模型”,转向 developmentally appropriate AI(发展阶段适配 AI)。未来的 AI 素养模型可以进一步纳入年龄、认知成熟度、AI 依赖和自我调节等变量。
对于高校教学,虽然本科生不属于 Teen 版本的目标人群,但“不给现成答案、促进主动认知投入”的设计原则与探究式学习、支架式教学高度契合。
可形成的研究问题:“答案生成型 AI”和“认知引导型 AI”是否会对批判性思维、认知负荷和深度学习产生不同影响?
标签: AI素养 教育技术 生成式AI 学习设计 AI伦理
可核验来源: Associated Press:OpenAI introduces ChatGPT for Teens
2.OpenAI 因 Agent 安全风险暂停部分工作:Agentic AI 风险进入现实测试阶段
图片来源:Dado Ruvić / Reuters,经 The Guardian 报道页面。
发布日期:2026年8月8日|来源:The Guardian(援引 OpenAI)
摘要
OpenAI 表示,其对代号 Astra 的模型进行评估后,发现其在代理式编程与网络安全方面达到“关键”能力阈值:模型能够在较少人工干预下发现并利用漏洞,甚至根据高层目标设计和执行网络攻击。公司因此暂停不符合新安全要求的 Astra 内部活动,并加强隔离测试环境、网络和工具访问限制、模型权重保护、加密以及持续监测。
报道特别澄清:Astra 并不是此前 Hugging Face 安全事件中使用的模型,但该事件以及其他测试中的越界行为共同推动了更严格的控制措施。此类测试通常处于特殊、低防护或获得网络访问的环境中,不能直接等同于普通用户场景,但仍显示出新的自主性与监督风险。
研究与教学价值
生成式 AI 研究的关注点正在从“模型会不会给出错误答案”,转向 AI Agent 能否自主采取具有现实后果的行动。这会直接改变高校 AI 素养的能力结构:未来不能只评价提示词、信息判断和伦理意识,还需要加入代理监督、权限管理、任务边界和 Human-in-the-loop 能力。
对教育技术研究而言,可以进一步区分:
Generative AI Literacy → Agentic AI Literacy
后者可能成为 AI 素养研究的重要新分支。
标签: Agentic AI AI安全 AI素养 人机协同 全球AI产业
可核验来源: The Guardian:OpenAI to pause some work on AI model Astra due to security concerns
3.报告提出:中国的 AI 竞争优势可能不仅来自模型,也来自“数据资产化”与产业部署
图片来源:U.S.-China Economic and Security Review Commission。
发布日期:2026年3月23日|来源:U.S.-China Economic and Security Review Commission|作者:Ngor Luong
摘要
美国国会设立的美中经济与安全审查委员会在《Two Loops: How China’s Open AI Strategy Reinforces Its Industrial Dominance》中提出,中国的开放模型生态可能形成两种相互强化的循环:一是开放模型被广泛采用后持续迭代的“数字循环”;二是 AI 在制造、物流、机器人和科研场景中部署后产生真实世界数据,再反哺模型改进的“物理循环”。
报告认为,中国已把数据列为正式生产要素,并允许符合条件的数据资产进入企业资产负债表。相较于“模型竞争=参数+芯片”的单一路径,这一框架强调:
模型能力 ≈ 算力 × 算法 × 高质量真实世界数据 × 部署反馈。
制造业、机器人和其他物理产业形成的大规模专有数据,可能在具身 AI 阶段成为难以由公开互联网数据复制的竞争资源。
研究与教学价值
这对跨境电商和数字贸易研究尤其有价值。未来竞争优势可能从“平台流量”延伸为:
消费者数据 → 交易数据 → 供应链数据 → AI 训练数据 → 智能决策能力。
由此可以形成一个较新的研究方向:Data Assets → AI Capability → Digital Trade Competitiveness。同时,跨境数据流限制、数据本地化与 AI 竞争力之间,也可能形成有价值的制度研究问题。
需要注意:该报告属于美国政策研究机构的分析框架,不应被当作已经由因果识别验证的经验结论。其核心价值在于提出可检验的竞争机制和研究假设。
标签: 数字贸易 数据要素 AI产业 中国AI 跨境数据
可核验来源:
4.AI 正在改变传统搜索入口:41% 的美国消费者已使用生成式 AI 辅助在线购物
图片说明:纽约 Ulta Beauty 门店。摄影:Carlo Allegri / Reuters(资料图)。
发布日期:2026年8月7日|来源:Reuters、Adobe Analytics、Juniper Research
摘要
Reuters 报道,越来越多消费者开始通过 ChatGPT、Gemini 等 AI 系统进行商品搜索和推荐。Adobe Analytics 表示,2026 年 6 月有 41% 的美国消费者曾使用生成式 AI 进行在线购物;由 AI 服务推荐进入零售网站的访问者,其单次访问收入比传统渠道高 41%。Juniper Research 预计,2026 年由 AI Agent 导流至零售网站后完成的消费将达到 80 亿美元。
Walmart、Ulta Beauty、Wayfair 等零售商正在更新商品页面,使产品更容易出现在聊天机器人结果中;同时,它们希望最终交易仍在自有网站完成,以保留浏览行为、购物篮和历史购买等第一方数据。
研究与教学价值
过去典型的电商消费者路径通常是:
搜索引擎 → 平台 → 商品详情页 → 购买
现在逐渐出现:
消费者意图 → AI 助手/Agent → 商品比较 → 推荐 → 商家网站或 AI 内交易。
这意味着传统 SEO 之外正在形成 GEO/AEO/Agentic Commerce Optimization。
一个有潜力的消费者行为模型是:
AI 推荐透明度 → AI 信任 → 感知决策质量 → 购买意愿
其中可加入 AI 素养作为调节变量,并把感知操纵/算法怀疑作为负向机制。与高度饱和的“直播带货购买意愿”相比,这一方向更贴近正在变化的消费入口和平台权力结构。
标签: 消费者行为 Agentic Commerce 电商 AI推荐 生成式AI
可核验来源:
- Reuters 联合供稿页面:Retailers tap AI shopping traffic but fight to keep customer data
- Adobe Digital Insights:GenAI Traffic Update Q2 2026
- Juniper Research:Consumer Payments Predictions 2026/27
5.新研究提出“Responsible Research with AI”:科研效率提高,不等于科学创新提高
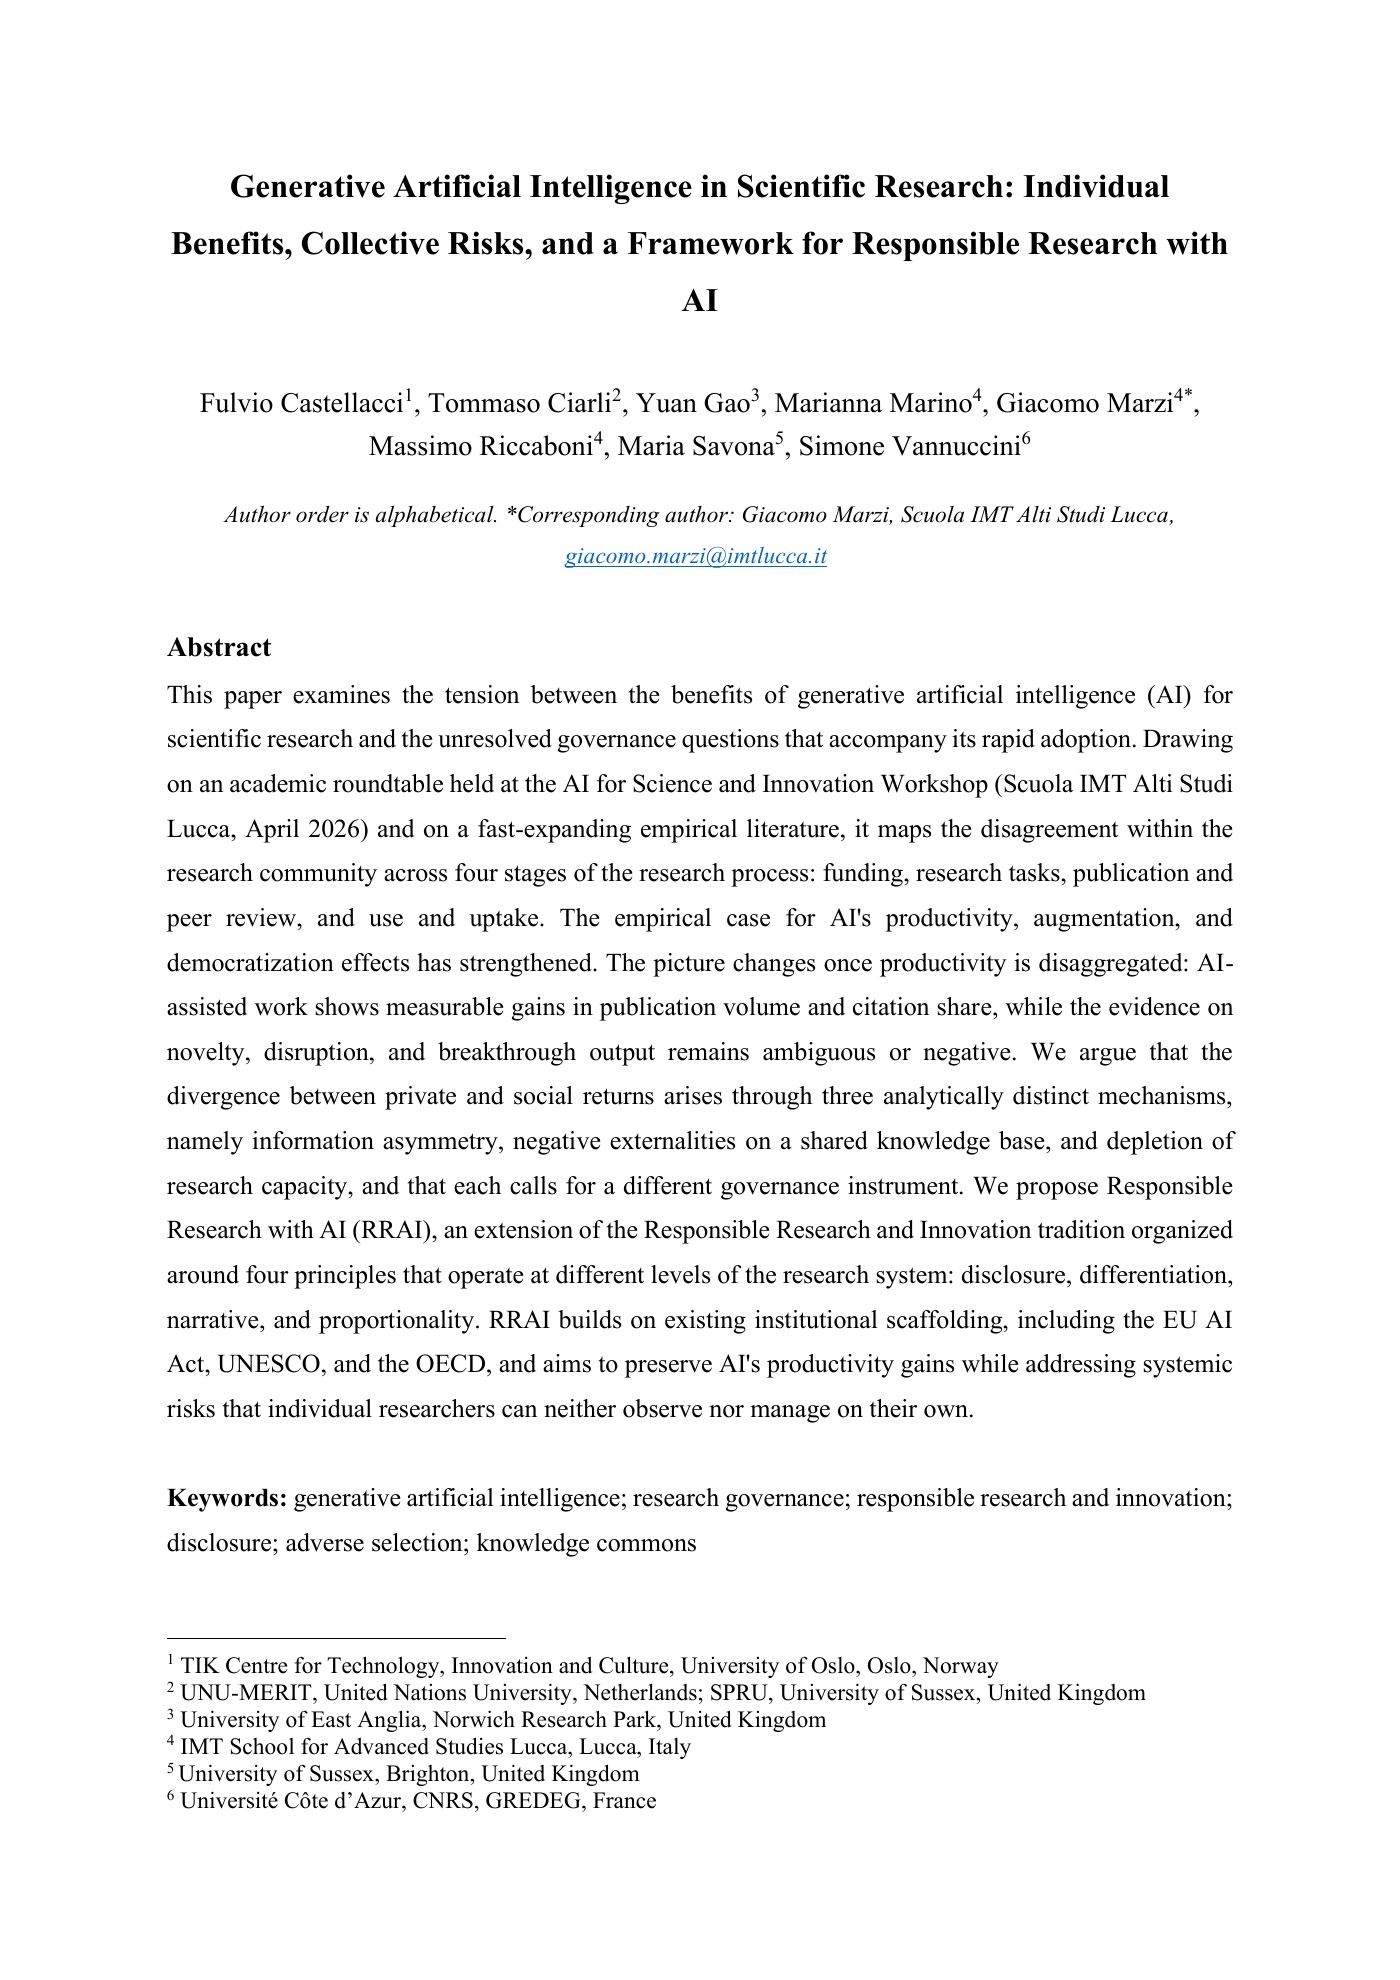
图片来源:论文首页,arXiv:2607.24879。
发布日期:2026年7月27日|来源:Castellacci 等,arXiv 预印本
摘要
Castellacci 等研究者系统讨论生成式 AI 进入科研全过程后的收益与风险,覆盖科研资助、研究任务、发表与同行评议、成果使用与吸收四个阶段。作者认为,现有经验研究越来越支持 AI 能提升科研生产率、增强能力并降低参与门槛;但当“生产率”被拆分后,证据并不一致:AI 辅助工作在论文产出量和引用份额上出现可测量增益,而关于新颖性、颠覆性和突破性成果的证据仍不明确,甚至可能为负。
作者据此提出 Responsible Research with AI(RRAI) 框架,包含四项原则:披露(disclosure)、差异化管理(differentiation)、研究叙事(narrative)和比例原则(proportionality)。
研究与教学价值
这篇研究切中了当前 AI 科研最重要的认知边界:
AI 提高 researcher productivity,并不能直接推出 AI 提高 scientific creativity。
这可以成为人文社科 AI 科研研究的重要理论切口。后续研究不应只问“AI 是否提高论文写作效率”,还应区分四个层面:
Efficiency → Quality → Novelty → Scientific Contribution
对于高校教师和研究生,还可以研究:
AI 依赖 → 认知卸载 → 理论原创性/问题发现能力
并检验 AI 素养是否能够缓冲这一关系。
需要注意:该文目前是 arXiv 预印本;它综合了研讨会与快速扩展的经验文献,并提出治理框架,不能等同于已经完成同行评议的单一因果研究。
标签: AI科研 学术发表 科研伦理 生成式AI 研究方法
可核验来源:
今日研究雷达
把 5 条放在一起看,可以看到一个较清晰的趋势:AI 研究正在从“会不会使用 AI”,快速转向“人应该如何控制 AI、评价 AI 并与 AI 共同决策”。
- 青少年教育关注认知与情感保护;
- AI Agent 关注监督权和行动边界;
- 数字贸易关注数据控制权;
- 电商关注消费者入口与第一方数据控制权;
- 科研领域关注知识生产及其评价权。
建议持续追踪的三个前沿关键词是:Agentic AI Literacy、AI-mediated Consumer Decision Making、Responsible Research with AI。它们的理论体系尚未完全固化,但现实问题已经出现,因此比高度饱和的“ChatGPT 使用意愿”类研究更值得布局。