每日文摘 · 2026-09-15
收录 2 条材料:The Scholarly Kitchen「Ask the Chefs」笔谈——八位从业者对同行评议产能的五条「不舒服的真相」与五条被忽略的对话(含 AAUP 教职结构数据:终身教职轨占比 1987 年 53.1% → 2023 年 31.8%);纽约市 K-12 生成式 AI 政策的完整细则(五款高中试点工具及每周使用时长的硬性上限、屏幕时间规定)——后者为 09-07 期条目的细节补充。逐条附证据分级与原文链接。
人文社科方法与学术出版
Scholarly Kitchen「Ask the Chefs」:同行评议产能的五条「不舒服的真相」
作者向八位「Chef」提了同样两个问题:关于同行评议,有哪一条学界谈得不够的「不舒服的真相」?以及,在「招募更多审稿人」之外,我们忽略了什么对话?
五条「不舒服的真相」
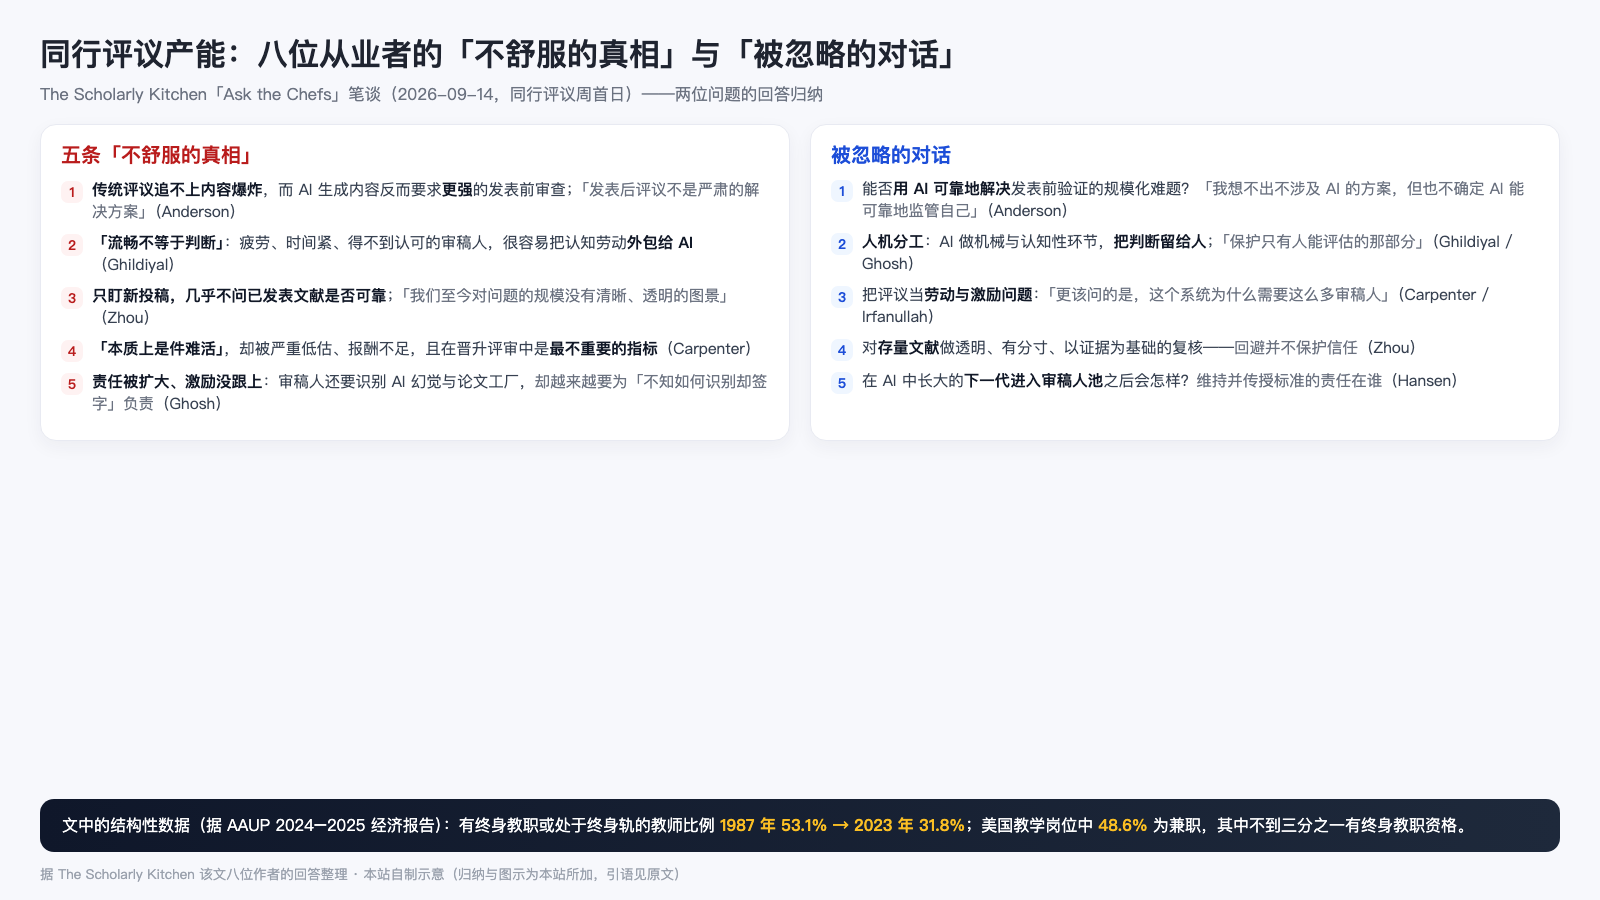
- 传统评议模型追不上内容的爆炸式增长,而 AI 让这件事更难。 Rick Anderson(杨百翰大学图书馆馆长):「根本性的、不舒服的真相是,传统同行评议模式没有办法跟上涌入系统的学术内容的爆炸式增长……让这成为一个棘手问题的是,当前这场爆炸的一个主要因素恰恰是 AI 生成的内容,它反过来要求对成果进行更强的发表前审查。抱歉,发表后评议不是一个严肃的解决方案;而不舒服的真相是,严肃且可规模化的方案很难想象。我想不出不涉及 AI 的方案,但我也不知道凭什么相信 AI 能可靠地自我监管。」
- 「流畅不等于判断」。 Ashutosh Ghildiyal:「期刊最终需要审稿人提供的是判断,以及为判断承担责任的意愿……对于疲劳、时间紧张且得不到认可的审稿人来说,依赖这些工具来做判断和认知工作的诱惑很高。问题在于:流畅并不等于判断。」他进一步指出:「评审是认知劳动。如果我们一边继续期待无偿审稿人提供基本不可见的认知劳动,一边 AI 又能轻松、免费地生成漂亮的评审报告,那审稿人越来越多地把这种认知劳动外包出去,就不该让我们意外。」
- 我们几乎不问「已经发表的那几百万篇」到底可靠不可靠。 Hong Zhou:「同行评议把大量注意力放在今天投来的稿子上,却很少追问既有的学术记录究竟有多可靠……有多少包含严重错误、被操纵的数据或图像、缺乏支撑的结论、不准确的参考文献,或者经不起细看的研究结果?我们至今对问题的规模没有清晰、透明的图景。」他补充:AI 与大规模分析工具正让系统复核变得可行,「困难的问题在于出版方和更广的研究共同体是否愿意去看——去看,可能意味着更多的更正、关注声明与撤稿,以及声誉与财务后果。但回避并不能保护信任」。
- 同行评议「本质上是件难活」,却被低估、报酬不足,在晋升评审中权重最低。 Todd Carpenter:「同行评议的不舒服真相是:它本质上是一件难活,而且被如此依赖它的共同体惊人地低估。」文中引述 AAUP 数据:有终身教职或处于终身轨的教师比例从 1987 年的 53.1% 降至 2023 年的 31.8%;美国教学岗位中 48.6% 为兼职,其中不到三分之一有终身教职资格。而在晋升评审中,「同行评议与其他学术服务是最不重要的指标」。
- 审稿人的责任被扩大了,激励却没有跟上。 Roohi Ghosh:「从识别 AI 幻觉,到发现论文工厂活动或 AI 的不当使用——审稿人的角色已经演化,但他们的激励没有……审稿人越来越需要为自己在并不完全知道如何识别这些错误的情况下签字负责。」Irfanullah 的措辞更激烈:「当前这种依赖人的同行评议系统正在让我们失望……它被高估、充满缺陷、具有剥削性、维持着长期的不公;其中人的面孔已经消失」,他甚至写道,这个系统如此不公,以至于**「100% 由生成式 AI 评审的预印本看起来是更好的替代方案」**。
五条「被忽略的对话」
- 能否用 AI 可靠地解决「发表前验证」的规模化难题?(Anderson)原文的追问是:「我们能否驾驭 AI,有效且可靠地解决我们在发表前验证学术产出时面对的这种极端规模问题?如果能,怎么做?」
- 让 AI 承担机械工作,把判断留给人。(Ghildiyal、Ghosh)「AI 可以支持评审中的机械性与认知性环节,但不应取代让人工评议真正有价值的人类判断」;Ghosh 的提法更具体:「我们如何保护同行评议中只有人才能评估的那部分?」
- 把同行评议当作劳动与激励问题,而不是招募问题。(Carpenter、Ghildiyal、Irfanullah)Carpenter 指向学术劳动结构的变化;Ghildiyal 主张让评议在认知上令人满足、在物质上有回报;Irfanullah 则质疑:不处理深层不公,每年九月讨论一周究竟能改变什么?
- 对存量文献做透明、有分寸、以证据为基础的复核。(Zhou)「这会让我们的学术记录更强,而不只是更好看。」
- 下一代进入审稿人池之后会怎样?(Hansen)她的问题是:「当在这些工具中长大、并信任它们的一代人成为基线、进入审稿人池时会发生什么?这是一条通往『AI 审稿人』的滑坡吗?维持并传授这一标准的责任在谁?」
另有一条值得单独记下:Alice Meadows 认为,两个问题在她这里是同一个答案——评议是一种共同体服务,真正有效的是培训(如 HHMI 的 TAP 项目、IOP 的 Peer Review Excellence),而非金钱激励;在 AI 生成的内容与评审「追着我们的脚跟」时,更要重申人对学术共同体为何不可替代。
⚠️ 证据边界:这是行业博客的专家笔谈,各条「真相」是从业者的判断与立场,不可作为经验证据引用,可引作行业内部认知的例证或用于界定研究问题。文中 AAUP 数据为该文引述(原始报告为 AAUP 2024–2025 经济报告),正式引用前建议回溯原始报告核对口径与年份。
为什么值得关注
- 它把「审稿人短缺」从职业道德问题重新定义为制度激励问题。 出版方的诊断(「很难让人接受审稿邀请」)停在现象层面;这篇接到了学术劳动结构上——终身教职轨占比从 53.1% 降到 31.8%、近半数教学岗位是兼职,而评议在晋升中权重最低。没有稳定教职的人,凭什么承担无报酬、不计入晋升的审稿劳动?
- 第 2 条对作者与审稿人是双向的。 「审稿人把认知劳动外包给 AI」与已收录的其他材料(Frontiers 关于研究者在评议中使用 AI 的调查、Nature 报道的可疑评议检测工具、arXiv 的一年封禁新规)合成一条链:作为作者,收到带 AI 痕迹评审意见的概率在上升;作为审稿人,自己的意见被机器检测的概率也在上升。 两端都在收紧。
- 第 3 条是一个现成的、几乎无人做的选题。 存量文献的可靠性评估,与 Scientometrics 的论文工厂撤稿研究正好是一体两面:已撤的是被发现的,未被评估的存量才是主体。 对教育技术这类文献增长快、早期方法规范较松的领域,做一次存量可靠性系统评估,选题价值与可行性都不低。
AI 与教育技术
纽约市 K-12 生成式 AI 政策:完整细则(对本站 09-07 条目的补充)
政策本身于 09-02 发布(本站 09-07 文摘已收录概要),本期取得的细则远比前期记录完整,对做 K-12 AI 政策研究有参考价值,故作为细节补充。
禁止范围:2-K 至 8 年级面向学生的生成式 AI;所有使用面向学生生成式 AI 的软件;所有年级的陪伴型聊天机器人(companion chatbots)。
允许范围:教师将 AI 用于教学设计与事务性工作(须符合纽约市公立学校安全标准);面向残障学生的辅助技术;对多语言学习者的支持;职业准备类项目(如计算机科学)。
高中试点:五款经审核工具,均设使用时长上限
| 工具 | 学科 | 时长限制 |
|---|---|---|
| Quill | 英语语言艺术 | 每周不超过 15 分钟 |
| Edia | 数学 | 每周不超过 20 分钟 |
| Brisk Teaching | 由教师设计活动 | 每次 10—20 分钟,每周 1—2 次 |
| Playlab | 跨学科 | 每评分周期不超过 2 次作业 |
| Intel AI-Ready Schools | 跨学科(学期项目) | 每周 1 课时 |
试点规模上限 50,000 名高中生(普通教育班级,约占全市在校生 5%);另为全体高中生开设每年两次的 AI 素养模块,每个模块 45 分钟。屏幕时间政策:2 年级及以下限制一对一屏幕时间;3—5 年级建议每日上限 30 分钟;6—8 年级建议每日上限 45 分钟。禁令覆盖约 60 万名公立学校学生,约占全市在校生的三分之二。
其研究价值在于它把「限制」做成了可测量的参数——每周 15 分钟、每评分周期 2 次作业、每日 30 分钟屏幕时间——而不是原则性表述。这与同期的**「赋能型」政策**(把 AI 能力写入毕业要求、设立教师 AI 大使一类做法)形成方向相反、且两端都有具体参数可比的对照;由于同为美国、同为 2026 秋季学期,混杂变量相对可控,是做「限制型 vs 赋能型」AI 教育政策比较研究时现成的一对样本。
📌 一处口径提示:官方表述「全美最广的面向学生的 AI 政策」是市长办公室的自我评价,未见第三方独立核实排名,此处按官方公告转载,不代为背书该比较性论断。