「谁来给我的作业评分?」:学生对 AI 打分的有条件信任
分析整理焦建利对 arXiv 预印本(AlGhamdi 2026)的解读,并回溯原论文逐条核对:沙特一所公立大学的《技术沟通》课上,19 名计算机专业学生当堂手写作业、由 ChatGPT 依量规给分与反馈,随后被明确告知「这份分数不是老师给的」;13 份手写反思浮现四个主题,核心是「有条件信任」——反馈有用就采纳,但评价权必须留在教师手里。附原论文的方法流程图、主题编码图与三原则框架。
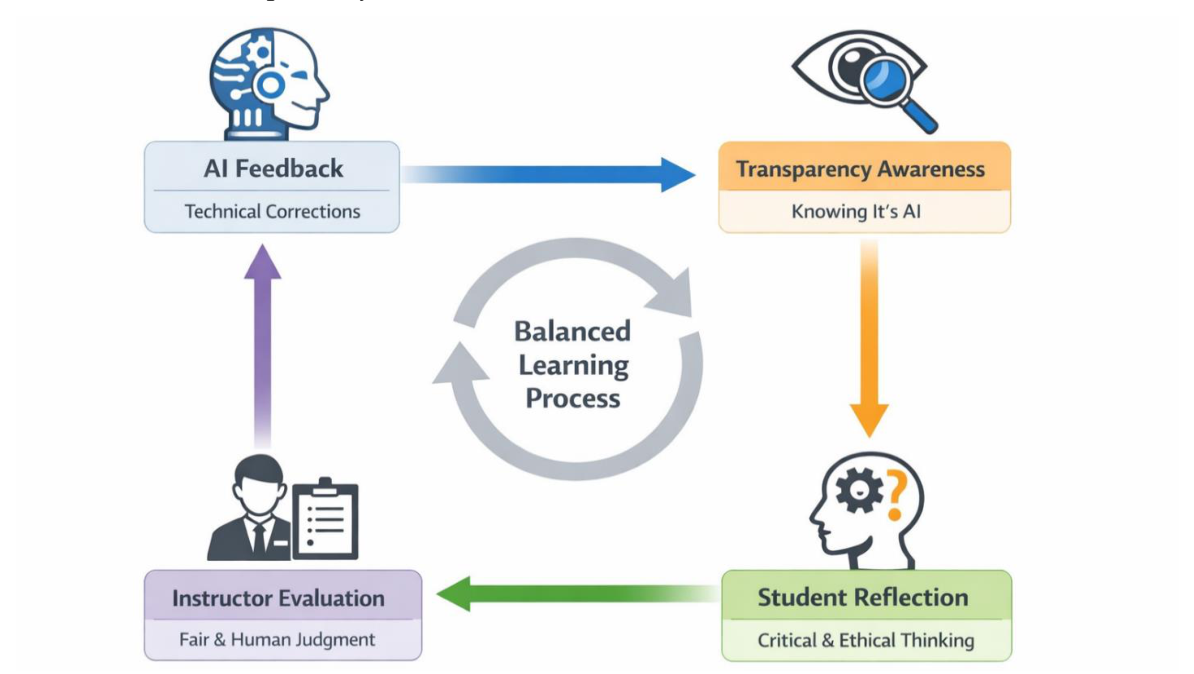
整理说明:本文整理自焦建利 2026-09-15 的解读文章(教育技术学自留地),并回溯原论文逐条核对——所有引文与数据以原论文为准。原文为 arXiv 预印本:AlGhamdi, R. (2026). Who Should Grade My Work? Student Perspectives on Transparent AI-Assisted Writing Assessment in Higher Education. arXiv:2609.05346(2026-09-04 提交,24 页)。配图均取自原论文(图 1、图 5、图 6、图 7),图注标明图号。
生成式 AI 越来越多地走进课堂,用大模型给作文写反馈、批改作业,已经成了一些地方 AI 教育应用的核心场景。一个很现实的问题随之而来:如果分数和评价本身就是 AI 给出的,学生知道真相之后会怎么想?
这篇研究没有去纠结「AI 打分准不准」,而是把目光投向学生的真实看法。作者在摘要里点明了研究的缺口:「相对而言,人们并不清楚,当学生被明确告知是 AI 系统而非人类教师产出了反馈与分数时,他们会如何理解这种评价」(comparatively little is known… about how students interpret such evaluation when they are explicitly informed that an AI system, rather than a human instructor, produced the feedback and the score)。
一、三个研究问题
作者提出的三个问题都很「接地气」(原文 1.1 节):
- 当学生知道反馈是 ChatGPT 产出的,他们如何评价这份反馈?
- 学生如何理解 ChatGPT 作为自己作业评价者的角色?
- 在学生的反思中,会浮现出哪些更广泛的教学与制度层面的关切?
当下不少研究热衷于验证「AI 反馈能不能提升写作成绩」,或测量「学生觉得 AI 反馈有没有用」;而学生知情之后的态度、信任与对评价权力的思考,受到的关注要少得多。这恰是本研究的位置。
二、研究怎么做的:一次嵌在真实课程里的教学探究
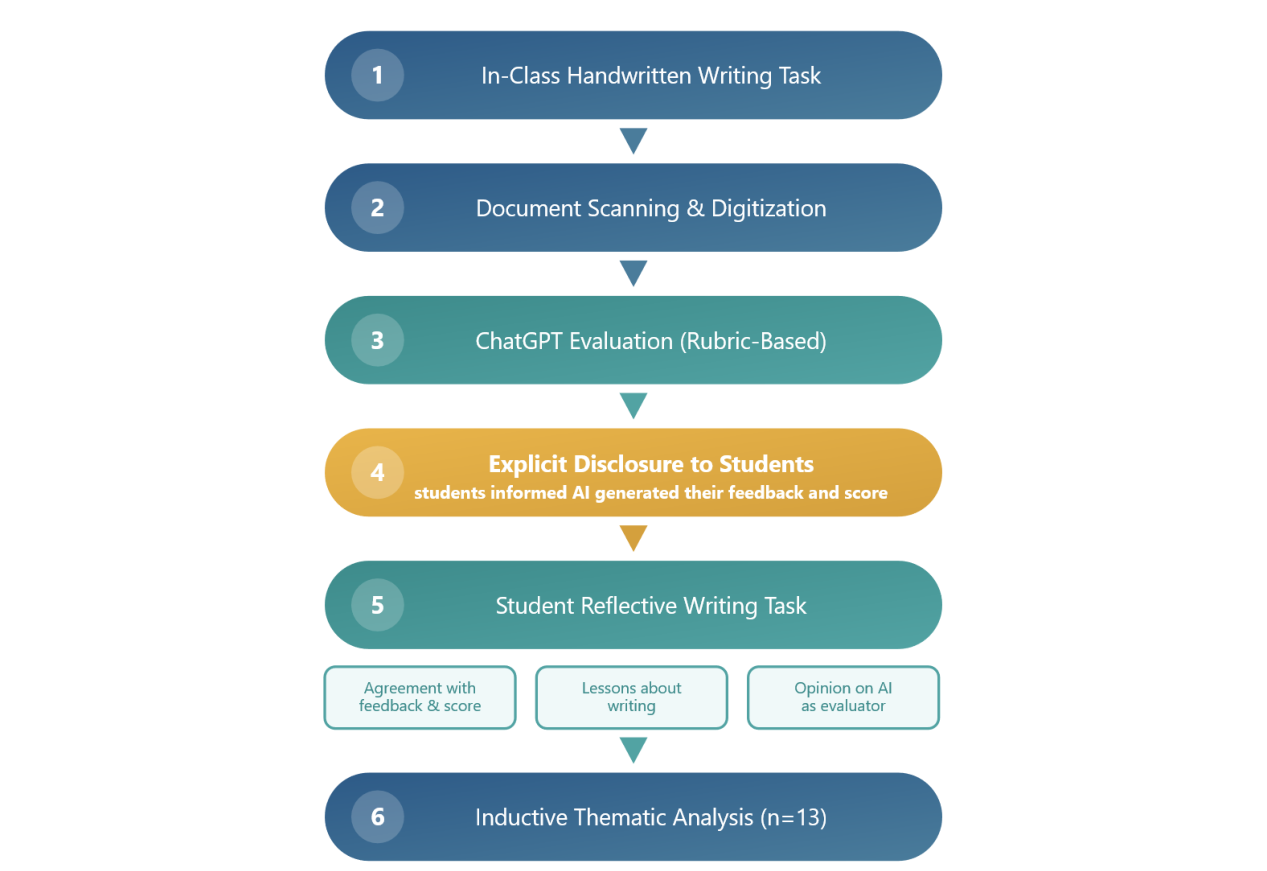
这是一项课程内嵌的质性教学探究,全部发生在真实大学课堂,不是实验室实验。作者本人就是该课程的授课教师,为计算机专业本科生讲授《技术沟通》。
- 参与者:同一教学班 19 名男生(大学二年级,入学前完成一年预科);其中 13 人完成了反思任务,构成最终分析样本。
- 写作真实性:学生当堂手写完成写作任务,避免 AI 代写;作业扫描数字化后再交给 ChatGPT。
- 关键干预(第 4 步):明确告知学生——这份分数和反馈由 ChatGPT 生成,并非教师批改。学生随后当堂手写反思,回答三件事:是否同意 AI 的分数与反馈及原因、从这次评价中学到了什么、如何看待用 ChatGPT 评价自己的写作。
- 分析方法:归纳式主题分析(Braun & Clarke)。第一轮由作者用 NVivo 做开放编码并提炼主题;第二轮把扫描件**独立交给 Claude Code(Anthropic,Opus 4.7 模型)**做验证性复核。作者特意强调这个顺序是刻意的——先人、后 AI,「以确保作者的分析判断不会被 AI 生成的框架所锚定」。
- 伦理处理:所有提交物在送交 AI 前匿名化;AI 评价被设计为课程内的常规教学活动而非额外研究程序,学生可拒绝将其反思用于研究;对「教师兼研究者」这一双重身份带来的回答偏差与权力不对等,作者列出了四项缓解措施,并承认「残余偏差无法在这种条件下被完全消除」。
一个对照组背景:作者此前在同一门课上做过盲测研究(AlGhamdi, 2024)——学生并不知道反馈来自 AI。本研究的关键变量就是透明披露。但作者明确说明:两项研究队列不同、学年不同、学生对 AI 的熟悉度也不同,不能做严格的因果比较。
三、四个发现:核心是「有条件信任」
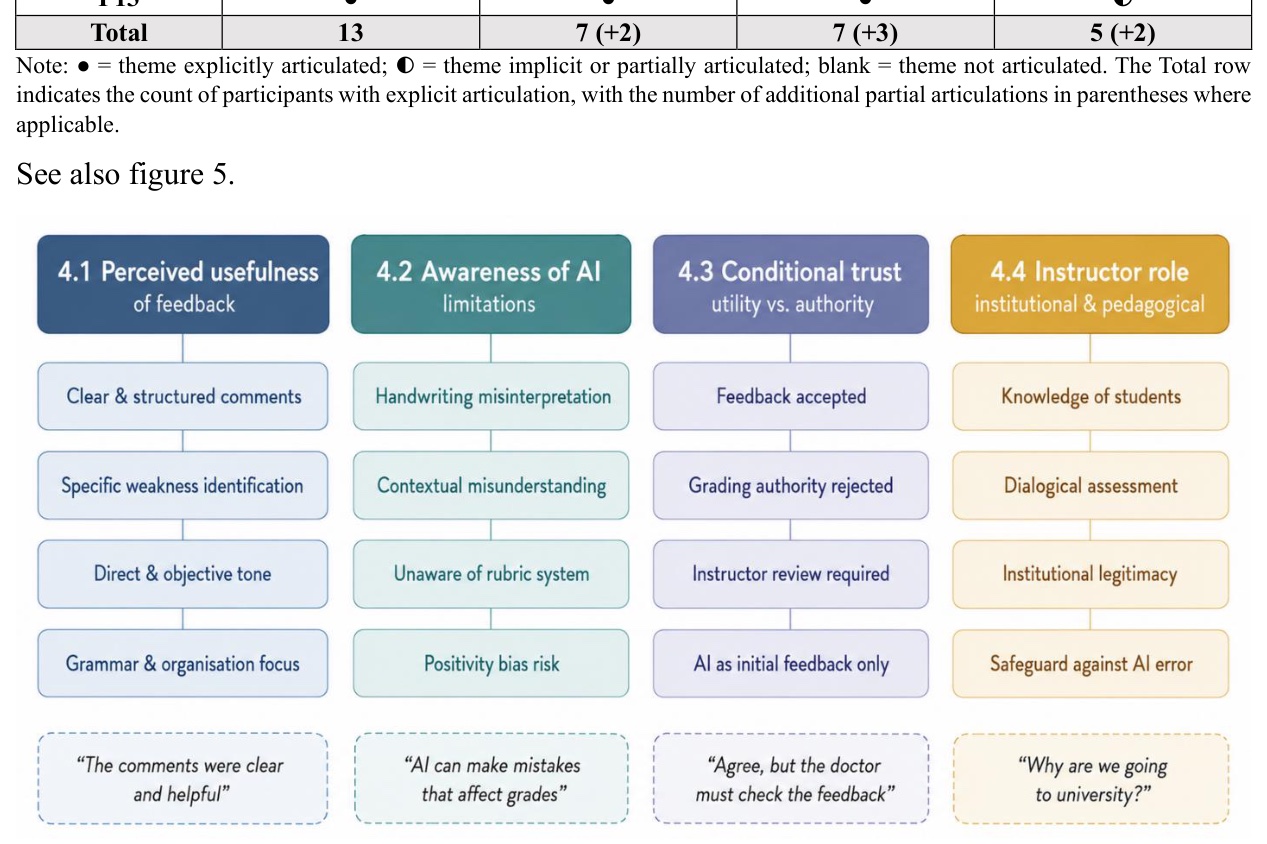
1. 反馈有用:13 人全部认可其实用价值
13 位参与者全部认为 ChatGPT 的反馈有用,尤其看重它指出具体问题(某个语法错误、某段组织混乱),而不是「需要改进」这类空泛评语。多人用「清晰」「直接」「有条理」「客观」形容它。一位学生写道:「这些评语很清楚,帮我理解了自己的错误,尤其是语法和句子结构方面。」另一位说:「它直接指出我的错误,给出具体的改进点……分数与解释完全对得上。」
作者指出,这种一致的好评本身就是一个值得注意的发现——因为其他研究里学生对 AI 的态度往往是分裂的。对大班课上反馈不足、反馈滞后的现实困境,AI 反馈确实能补上一部分缺口。
2. 看得见局限:技术局限与语境局限
学生并不是盲目迷信 AI。他们提出的局限分两类:
- 技术层面:手写扫描可能被误读。一位学生说:「我注意到它把我的姓拼错了,还认为我拼写有错误——但我并没有。我想是因为我的笔迹,它一定读错了。」他补充:「我也会不那么当真地看待它的分数,因为如我所说,它可能读错词、做出错误假设。」另一位说得更直接:「AI 会犯错,而这些错误会影响学生的成绩。」
- 语境层面:AI 不熟悉本门课的评分体系——「AI 评分有个问题:它并不知道(老师的)评分体系」;还有学生会觉得它一味讨好:「AI 总是试图正面评价,但这不意味着它不能用。我觉得可以把它当作初步反馈。」
作者由此判断:至少有部分参与者并没有把 ChatGPT 的评价当成中立、无误的,他们会主动质疑其准确性与可靠性,尤其是在语境理解与意义辨识方面。
3. 核心洞见:区分「反馈效用」与「评价权威」
这是全篇最具分析价值的模式,也是论文自称的核心概念贡献:
学生可以同时肯定 ChatGPT 反馈的有用性,又拒绝让 ChatGPT 充当最终评价者。他们在「这份反馈有用」与「这个系统不该决定我的分数」之间划出了稳定的界线——这两种判断在分析上是彼此独立的,而不是同一条认可刻度上的两端(These were treated as analytically separate judgements rather than two ends of a single approval scale)。
学生的原话把这个区分表达得很清楚:
- 「我同意它的反馈,但有一个条件:老师必须检查这份反馈,改掉其中的错误。」
- 「老师可以只用 AI 来读考试反馈;但如果用它来给学生打分,问题就会出现。」
- 「ChatGPT 和人不一样。你可以跟人说话、解释你的理由,请他考虑或者再给一次机会……我更愿意让正常的老师来给我的作业评分。」
值得注意的是,这种「有条件信任」在最喜欢 ChatGPT 的学生身上同样存在:有人把 ChatGPT 称作「你自己的老师」,但这一认可指向的是学习支持,而不是评分权;还有一位起初「怀疑」的学生最后建议「更多老师至少该试试用 AI,尤其是做反馈」——认可同样止步于反馈,未延伸到评价。
4. 教师为什么不可替代:四类理由
学生的反思并没有停在「AI 技术上有局限」,而是给出了人为什么必须留在评价环节的理由,论文归纳为四类相互关联的论证:
- 老师了解每个学生的个体情况:「老师更懂学生,也更知道怎样给学生打分、怎样支持学生的学习。」
- 评价是对话性的人际实践:可以解释、可以申诉、可以争取「再给一次机会」——而不只是单向判定。
- 大学的制度合法性:「如果 ChatGPT 来检查考试,那我们为什么还要上大学?为什么不直接跟 ChatGPT 学、在 ChatGPT 里自己考自己?」——这一问不是关于反馈质量,而是关于把评价交给 AI 之后,正规高等教育的意义与合法性。
- 防止 AI 错误落到学生头上:「AI 会犯错,而这些错误会影响学生的成绩」——教师因此被看作兜底的安全阀。
作者强调:这些理由不是对技术的简单抗拒,而是主动为「人类评价权威应当保留」给出的正面论据(Participants were not rejecting AI; they were articulating positive reasons…)。
主题分布(原论文表 1):主题 1 有 13/13 人明确表述,主题 2 有 7 人(另有 2 人部分表述),主题 3 有 7 人(另有 3 人部分表述),主题 4 有 5 人(另有 2 人部分表述)。
四、三原则框架,以及一个被低估的设计动作
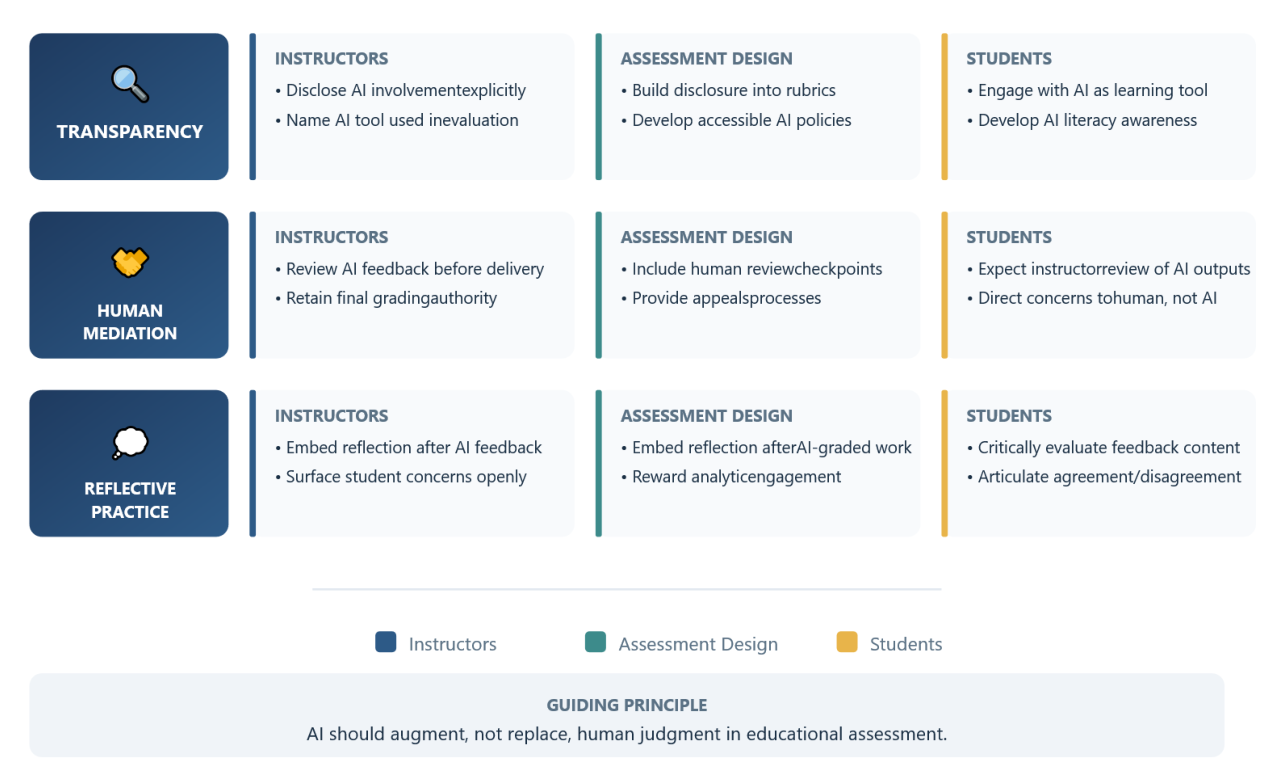
框架围绕三条原则展开,每条原则都分别落到教师、评价设计、学生三个对象上:
- 透明性(Transparency)——教师明确披露 AI 的参与、点名用的是哪个工具;评价设计把披露写进评分量规、制定可及的 AI 政策;学生把 AI 当学习工具、发展 AI 素养。
- 人类中介(Human Mediation)——教师在交付前审阅全部 AI 反馈、保留最终打分权;评价设计设置人工复核节点、提供申诉通道;学生期待教师复核 AI 输出、把疑虑直接对人说。
- 反思实践(Reflective Practice)——教师在 AI 反馈之后嵌入反思、让学生把担忧摊开讲;评价设计在 AI 评分之后安排反思、对分析性参与给予回报;学生批判性评估反馈内容、明确表达同意或不同意。
框架底部写着一句总纲:「AI 应当增强,而不是取代,教育评价中人的判断。」(AI should augment, not replace, human judgment in educational assessment.)
一个容易被忽略但很关键的设计动作:这项研究把反思放在拿到分数之后(post-assessment reflection),而不是写作或修改过程中。论文 5.4 节说,这个时序选择「被证明是有后果的」——它把学生的注意力从「这句话该怎么改」推向了「谁应该来评价我的作品」「AI 在评分中该扮演什么角色」这类系统性问题。作者进一步提出:透明不只是伦理义务,也可能是一种教学策略——它支持了学生的批判性参与,而不只是合规要求。
五、局限:作者自己划的边界
- 样本小且可能自选:13/19 人提交了反思;作者认为对同质、有界的样本做反身性主题分析是够的,且主题饱和在数据内较明显,但不能推论到其他人群。
- 高度同质:全部为男性、计算机专业、单一沙特公立大学、单一班级、单一教师、单一学期——跨性别、跨学科、跨机构、跨文化的可迁移性受限。
- 教师兼研究者的回答偏差:缓解措施已列出,但无法完全排除。
- 与前作不可作因果比较:队列、学年、AI 熟悉度都在变,无法把「透明」的效应从队列效应、时间效应中分离出来。
- 图 6 的模型是理论综合,不是经过检验的因果路径;作者认为最有价值的后续方向,是在同一队列内做「盲测 vs 透明」的对照实验。
写在后面
读完这篇,最值得带走的是那个概念区分:反馈效用与评价权威是两件事。学生可以一边说「这份反馈写得好、有用」,一边坚持「分数不能由它定」——这不是模棱两可,而是把两个不同的问题分开回答。
今天是不少教师已经在用大模型批改作业。这篇研究给出的三个自问,我认为可以直接拿来用:
- 我们用 AI 生成反馈甚至分数时,有没有告诉学生真相?
- 我们有没有把最终评价权握在教师手里,并留下可申诉的通道?
- 我们有没有给学生机会对 AI 的评判提出质疑、表达不同意见?
还有一点方法层面的收获:这项研究最有说服力的地方,不是「学生说 AI 反馈有用」,而是它把「是否告知」当成了一个可设计的变量——作者此前做过盲测版,这一版做了透明版。虽然两版之间不能直接比较(作者自己也反复强调),但**「同队列内盲测/透明对照」这个方向已经被作者点名**,谁先做出来,谁就拿到这个题目最硬的那块证据。
来源:原论文 · arXiv:2609.05346(AlGhamdi, R., 2026-09-04)|解读:焦建利《谁应该给我的作业评分?》(2026-09-15)|文中引用的前作:AlGhamdi, R. (2024). Education and Information Technologies, 29(14), 18901–18926(盲测研究)