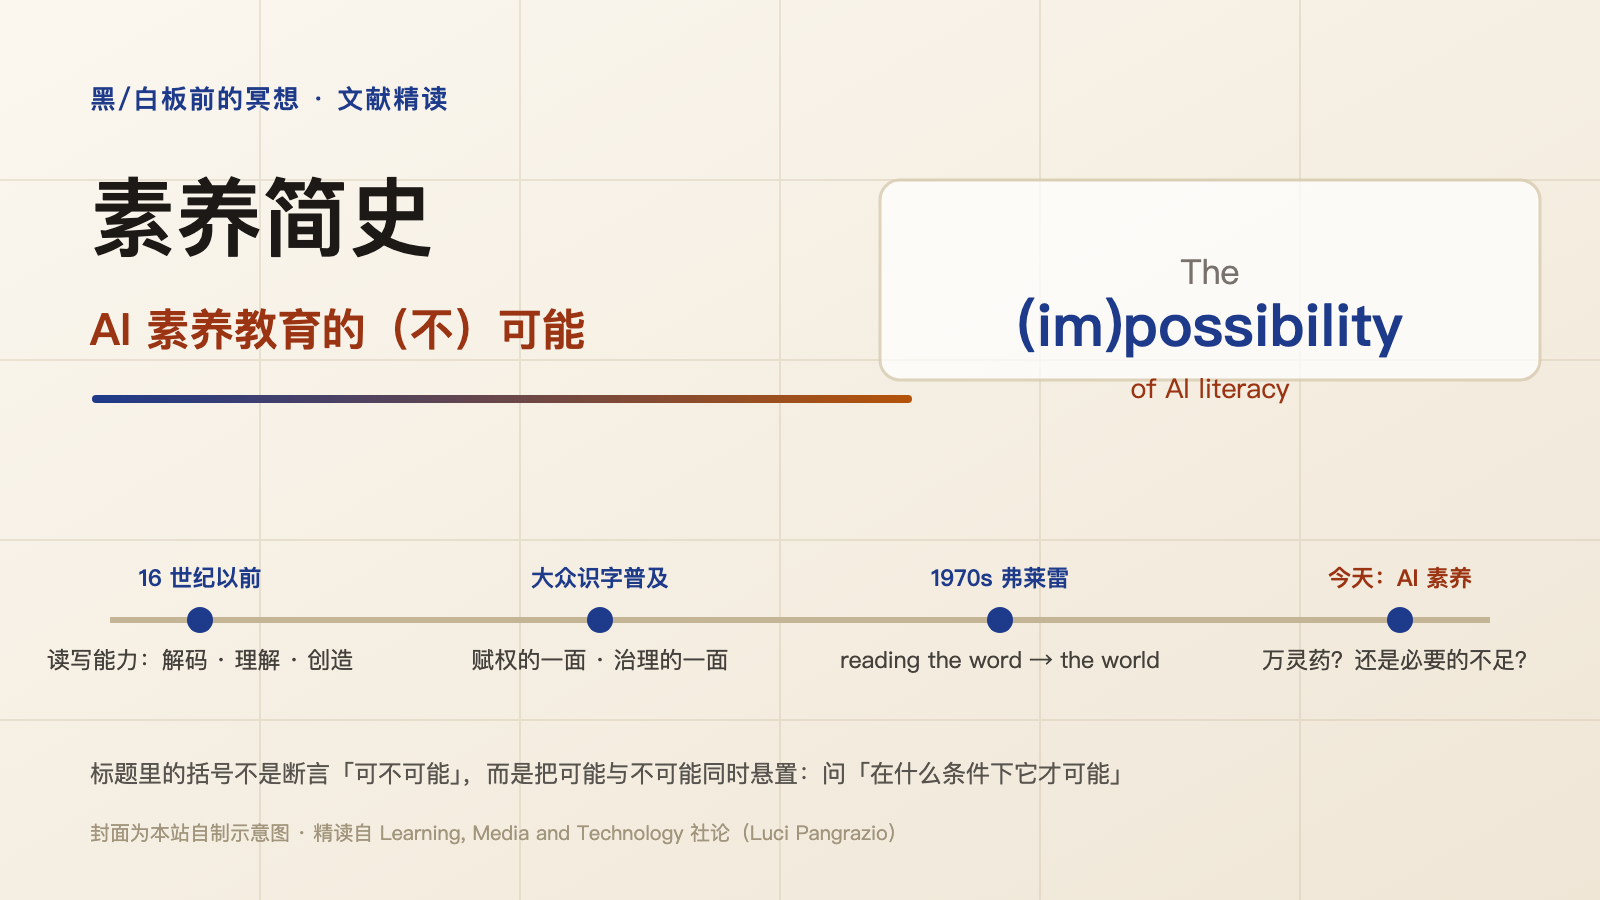
素养简史:AI 素养教育的(不)可能
精读 Learning, Media and Technology 的一篇社论《The (im)possibility of AI literacy》:从 literacy 的四百年简史(读写能力 → 赋权与治理的两面 → 弗莱雷的 critical literacy)出发,追问 AI 这种学习对象是否适合被「素养化」,并指出素养之外的两种解——权利与主权。
整理说明:本文整理自李小祖逸《素养简史:AI 素养教育的(不)可能》,精读对象为 Learning, Media and Technology 的社论《The (im)possibility of AI literacy》(作者 Luci Pangrazio,澳大利亚迪肯大学副教授);正文保留作者第一人称与原有表述,封面与示意图为本站原创。
今天看了一个很好的社论(Editorial),发表于 SSCI 一区期刊 Learning, Media and Technology——这是一个以“教育技术批判研究”为特色的期刊。世界之大无奇不有,还有这种期刊定位。
我今天要讲的这篇文章就跟有代表性。看标题:The (im)possibility of AI literacy。
标题里的括号 (im) 是非常后现代主义的写法(德里达):这个标题不是断言“AI 素养可不可能”,而是把可能与不可能同时悬置——问的是”在什么条件下它才可能“。它想探讨的问题是:
- AI 这种学习对象,究竟是否适合被“素养化”?
- 即便可以,它还能不能沿用我们熟悉的 literacy 模型?
作者 Luci Pangrazio 是澳大利亚迪肯大学副教授。写这篇社论不是一时兴起的:她 2018 年前后就在研究青少年数字素养和个人数据素养(Personal Data Literacies),2023 年已经开始做“批判数据素养”的系统化,2024 年至今的主要研究方向在于”素养作为治理“。
作为一个“素养研究专家”,Pangrazio 关注到一个有趣现象:围绕 AI,乐观派和悲观派意见完全相反——有人期待 AI 增强能力、提高生产力,有人担心失业、环境影响以及思维和学习方式的改变。
这个现象我们也观察到了;我们没观察到的是:但两边居然经常强调同一个解决方案——AI literacy。 似乎只要人具有 AI 素养,就能够既避免 AI 风险,又充分发挥 AI 潜力。
于是作者开始警惕:literacy 正在变成一种 “cure all(万灵药)”,一个面对 AI 复杂问题的万能教育解决方案。
一、素养简史:先别谈 AI,先了解一下素养
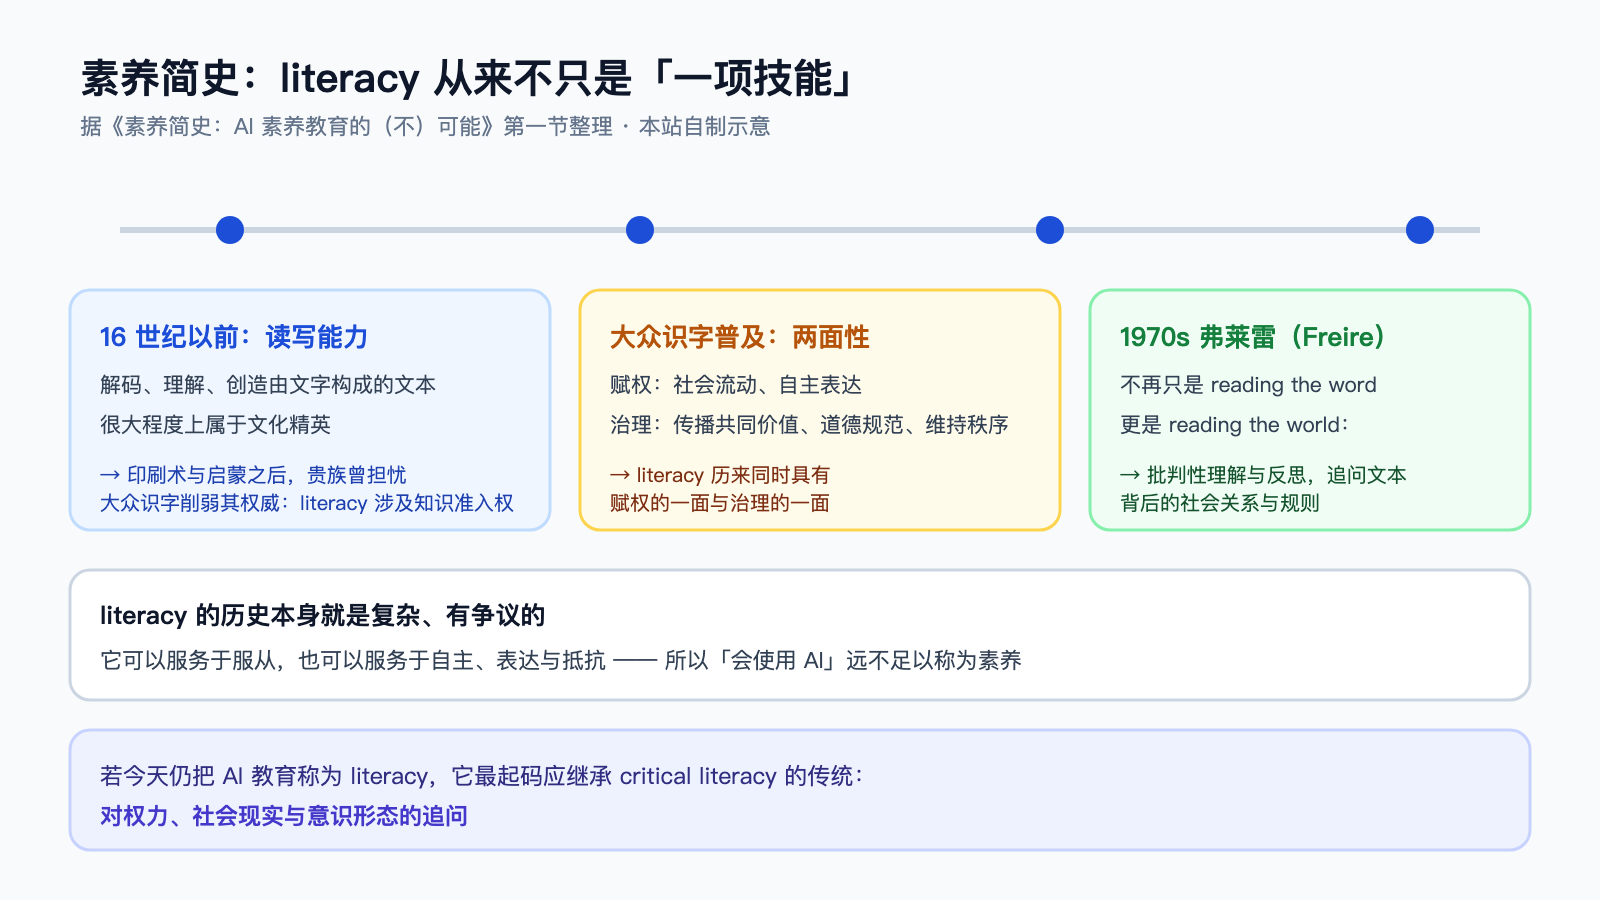
在 16 世纪以前,素养(literacy)就是读写能力:解码、理解和创造由文字构成的文本。所谓“读写能力”很大程度上属于文化精英。作者特别提到,随着印刷术发展和启蒙运动的兴起,贵族还曾担忧大众识字会削弱他们的权威——所以 literacy 从一开始就不只是“一个人大脑里有没有某项技能”,它还涉及知识准入权。
大众识字教育普及以后,它一方面帮助个人获得社会流动和自主表达的能力;另一方面,也曾被国家和教育制度用于传播共同价值、道德规范并维持社会秩序。换言之,literacy 历来同时具有赋权的一面,也有治理的一面。
接下来作者一下从 19 世纪跳到 1970 年代,到了弗莱雷(Freire),这个概念又发生了一次重要变化。“素养”不再只是读写能力(reading the word),更是”见众生(reading the world)的批判性理解和反思能力。人不仅应该会读一个文本,还应该能够追问文本背后的社会关系和规则。
所以 Pangrazio 强调,literacy 的历史本身就是复杂、有争议的:它可以服务于服从,也可以服务于自主、表达与抵抗。 如果今天还要把 AI 教育称为 literacy,那么它不能只剩“会使用 AI”,它最起码应该继承弗莱雷的 critical literacy 对权力、社会现实和意识形态的追问。
二、现有的 AI 素养模型有何不足?
她看了近年来几类代表性的综述和模型,例如吴子杰(Ng et al., 2021)等人的框架。在这些模型中,AI literacy 通常包括:应用 AI、创造 AI,以及伦理层面评价 AI。
她的判断是:伦理层面评价 AI 确实最具批判取向,也最难,但此后所有模型都只说“要做”,没说“怎么做”。
传统的批判式素养可以批判性反思“文本”——分析一本书、一部电影、一则广告是怎样构造意义的,揭示意义如何通过构成要素被生产,识别互文、假设、矛盾。
可 AI 能这样被分析吗?AI 的文本显然不能被当作反思的对象,可那该反思谁呢?是算法?是大语言模型?是训练数据?无论你有什么招,现在的问题是对手无法被选中。
困难一:AI 远比我们想象地“大”
我们很容易把 AI 想象成 ChatGPT:“我决定打开它,然后使用它。“这样确实容易谈 AI literacy:什么时候应该用?怎么验证?怎样伦理使用?
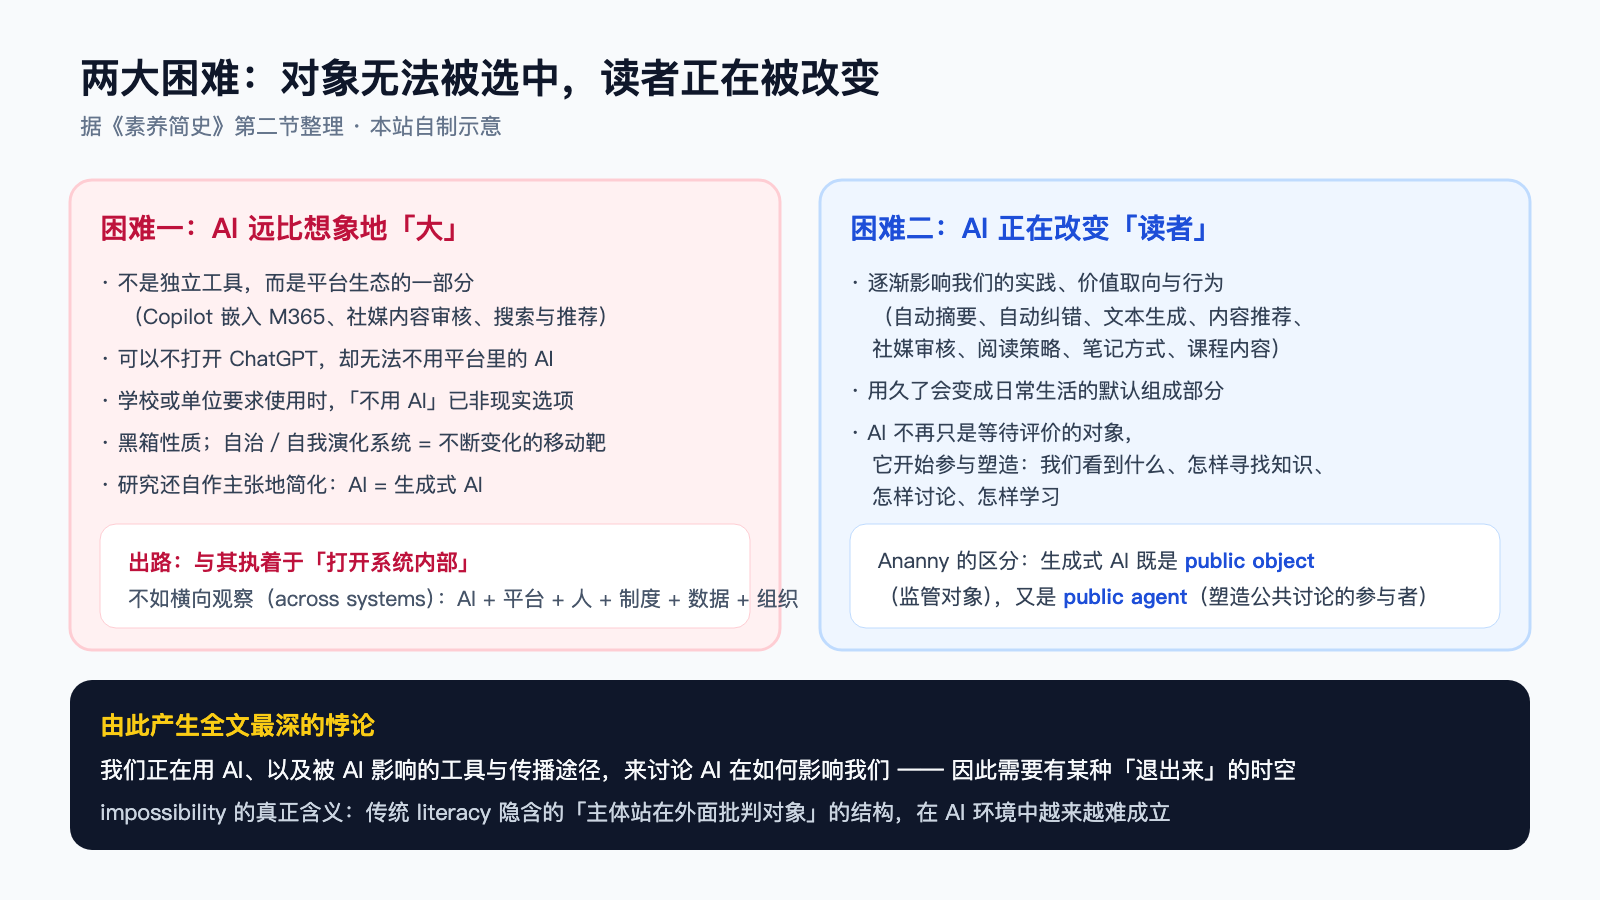
但现实里的很多 AI 已经不是一个独立工具,而是平台生态的一部分。例如 Copilot 嵌入 Microsoft 365,社交媒体使用 AI 进行内容审核,其他平台也把 AI 放进搜索、推荐和日常功能中。
结果是:有时候我们可以选择“不打开 ChatGPT”,却不能选择“不使用平台里的 AI”。尤其当学校或者工作单位要求使用某个平台时,“不用 AI”甚至已经不是一种现实选择。AI 系统本身具有黑箱性质,普通用户很难理解它内部究竟怎样工作;一些自治或自我演化系统还会根据任务和环境调整内部机制,所以 AI 变成一个不断变化的“移动靶”。
作者进一步指出,目前不少所谓 AI literacy 研究还自作主张地完成了另一个简化:AI = 生成式 AI。ChatGPT 等生成式 AI 成为主要讨论对象,而社会中大量推荐、审核、预测、自治型 AI 系统反而被忽略。
作者也不满足于悬置这些问题,而是建设性地指出:与其执着于“把系统内部打开”,不如**横向观察(across systems)**它与其他系统发生了什么关系。也就是说,真正值得研究的可能不是单独一个模型,而是:AI + 平台 + 人 + 制度 + 数据 + 组织组成的“生态系统”。
因此,更完备的 AI 素养应教人理解:AI 进入什么制度?改变什么关系?谁因此被赋能?谁失去选择?
困难二:更麻烦的是,AI 还在改变“读者”
“AI”作为研究对象,由于边界的嵌入性,很难被选中;更难的是,它还在改变它的使用者。
作者认为,AI 正在逐渐影响我们的实践、价值取向和行为。例如:搜索结果自动摘要、自动纠错、文本生成、内容推荐、社交媒体审核、阅读策略、笔记方式、课程内容……这些东西使用久了以后,会逐渐变成日常生活的默认组成部分。AI 不再只是一个站在我们面前、等着我们评价的对象,它也开始参与塑造:我们看到什么、怎样寻找知识、怎样讨论以及怎样学习。
作者引用 Mike Ananny 的一个特别漂亮的区分:生成式 AI 既是一个 public object——公众讨论和监管的对象;同时又是一个 public agent——它本身参与塑造公众讨论及其发生的公共空间。
于是产生了全文一个很深的悖论:
我们正在用 AI 和被 AI 影响的工具与传播途径,来讨论 AI 在如何影响我们。
作者甚至提出,我们需要有某种时间和空间“退出来”,观察 AI 怎样改变我们的行为和实践;否则,用来批判 AI 的工具和讨论场所本身都已经受到 AI 塑造。
到这里,标题里的 impossibility 才真正出现。AI literacy 并非“不可能”或者“没意义”,而是传统 literacy 隐含的那种结构——一个主体站在外面,阅读和批判性反思一个对象——在 AI 环境里越来越难成立。
还有第三个问题
接下来 Pangrazio 换了一个角度:即使前面的问题都能够解决,她还有一个疑问——为什么我们好像把 AI literacy 当成了一个全新的教育领域?
数字素养研究已经发展近 30 年,其中早已有大量关于数字平台、媒体、信息、算法、商业权力、数据和批判性使用的研究。然而今天很多 AI literacy 论文却总是重新从“AI literacy 还没有被明确定义”开始。作者认为,这在某种程度上忽视了数字素养(digital literacy)和媒介素养(media literacy)已经积累的理论传统。
而且 digital literacy 的历史还给我们留下了一个不太乐观的现实:几十年的“数字素养”研究并不意味着学校已经把数字素养教育做得很好。作者引用澳大利亚和 ICILS 的数据说明,一些正式测评中的学生数字能力甚至出现下降。
作者推论:如果教育系统没有能力建立强健、持续的 digital literacy 教育,谁会进来填补这个空缺?——科技公司。 这里并非在说科技公司不懂教育,而是科技公司为了利益都能宁可让科技发展慢一些(如:谷歌搜索的广告收益和 Gemini 发展的矛盾),那么科技公司会定义出怎样的“AI 素养”?
因此作者担心素养被商业俘获(commercial capture):表面上是在培养 AI 素养,实际上逐渐变成产品使用培训。
三、那该怎么办?
最后一节作者把前面的批判收回来。她从头到尾都没有说“AI 素养是错误的,应该废除”这样的话。她说的是:我们不应该把 AI 素养当作帮助学习者理解和驾驭 AI 的“万能解”。
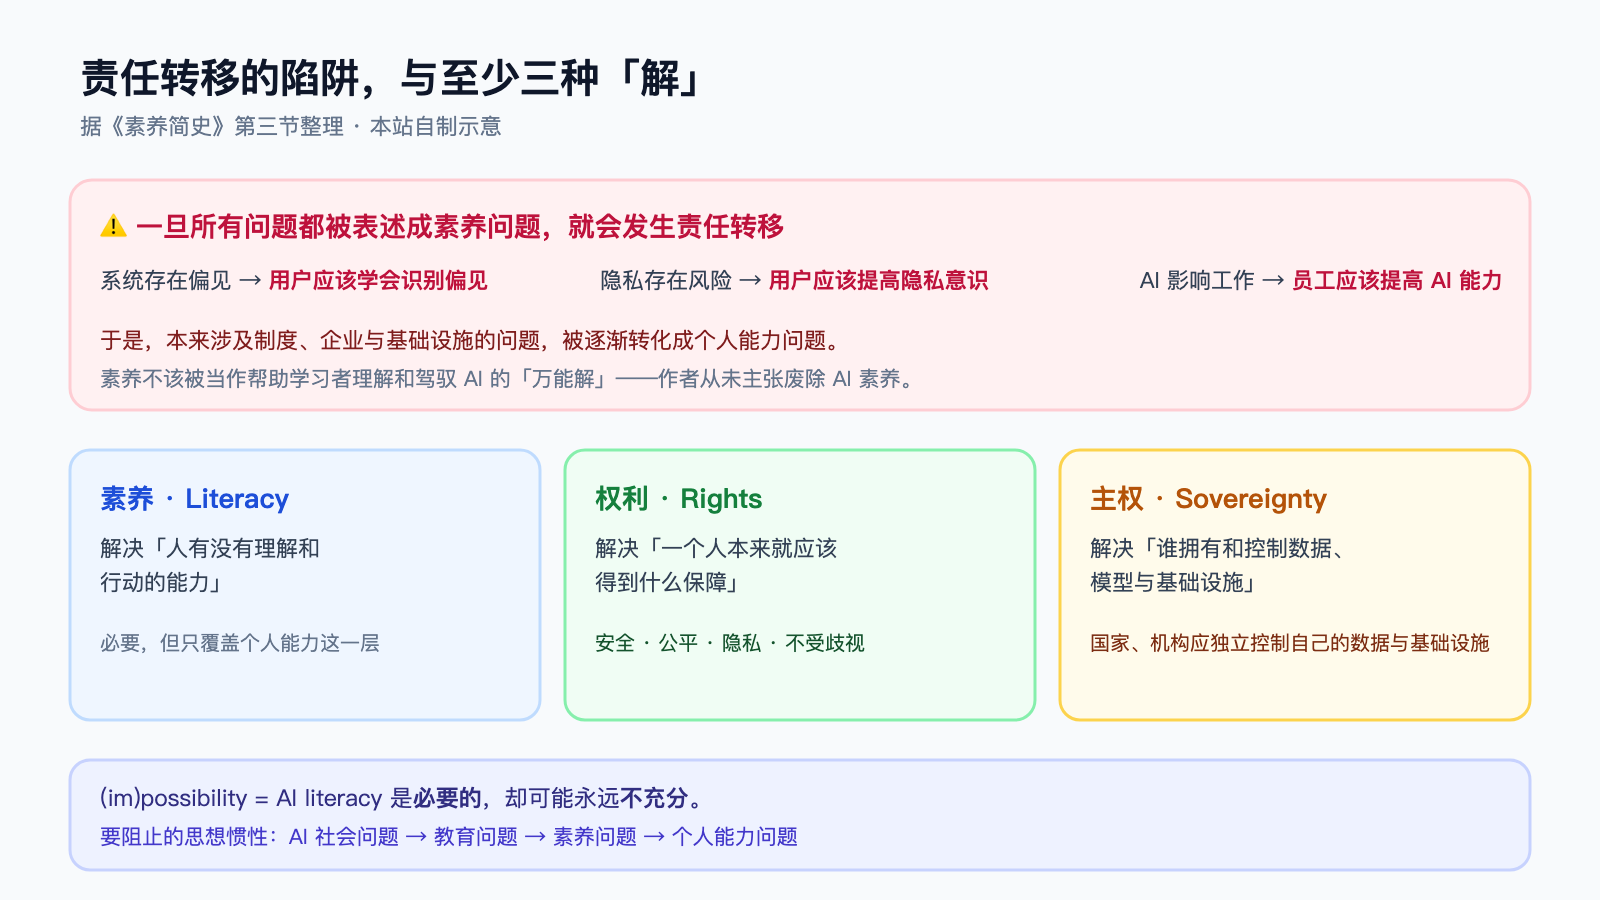
一旦所有问题都被表述成素养问题,就容易发生一个非常重要的责任转移。例如:
- 系统存在偏见 → 用户应该学会识别偏见;
- 隐私存在风险 → 用户应该提高隐私意识;
- AI 影响工作 → 员工应该提高 AI 能力。
于是本来涉及制度、企业和基础设施的问题,被逐渐转化成个人能力问题。
文章提出最后也是最重要的扩展:面对 AI,我们可能至少需要三种“解”同时存在:
- 素养(Literacy):解决“人有没有理解和行动能力”;
- 权利(Rights):解决“一个人本来就应该得到什么保障”——安全、公平、隐私、不受歧视;
- 主权(Sovereignty):解决“谁拥有和控制数据、模型与基础设施”,国家、机构或组织应当独立控制自己的数据与基础设施。
此外,作者还提到,考虑到 AI 的不透明与快速演化,思辨(speculation)与诠释(interpretive)式研究方法可能比很多平庸的实证研究更靠谱。
结语:作者究竟想干什么
回顾一下,全文其实只有一条论证线。
文章开头问:AI 给大家出了这么多难题,为什么我们的答案总是“提高 AI 素养”? 然后作者做了三步论证:
- 先回到素养简史,发现:素养依赖于对文本的理解和批判性反思;
- 再考察 AI 这种对象,发现:AI 既不像培养素养的“文本”,又已经进入并塑造我们阅读世界的环境;
- 最后回到教育政策:有些 AI 引发的问题确实需要人提升能力,但另外一些需要权利保障和基础设施层面的改变。
所以标题中的 (im)possibility 的含义是:AI literacy 是必要的,却可能永远不充分。
而这篇文章真正想阻止的,是我们过早形成这样的思想惯性:
AI 带来的社会问题 → 教育问题 → 素养问题 → 个人能力问题。
很荣幸,和你一起读了一篇这么精彩的文章。
来源:李小祖逸《素养简史:AI 素养教育的(不)可能》|精读对象:Pangrazio, L. The (im)possibility of AI literacy. Learning, Media and Technology(社论)