从「课程」到「学习过程」:吴恩达的新公司想重新发明学习的基本单位
Coursera 投资 1 亿美元给吴恩达的新教育公司 LearnVector。整理这条新闻,也整理一个对教师很重要的问题:当 AI 能做助教之后,学习的基本单位还是「一门课」吗?
本文为公开报道的整理与教学随笔,素材来自 LearnVector 官网、吴恩达公开信及多家媒体报道(2026 年 8–9 月),观点与引语均保留出处原意;配图为本站原创示意图。
吴恩达又做了一家教育公司,名字叫 LearnVector。而给这家公司投钱的,是他当年参与创办的 MOOC 平台 Coursera——2026 年 7 月,Coursera 宣布向 LearnVector 投资 1 亿美元、获得约三分之一股权,也就是说,这家连正式产品都还没发布、要到 2027 年初才展示第一批产品的公司,估值已接近 3 亿美元。
Coursera 本来就是全球最大的在线课程平台之一,AI 助教 Coursera Coach、课程生成工具 Course Builder、AI 角色扮演、自动评价、个性化路径,它全都有。既然如此,为什么吴恩达不直接在 Coursera 里改,非要另起炉灶?
答案或许在于:Coursera 已经把「课程」做到了极致,而 LearnVector 想重新定义的,恰恰是「课程」本身。
一、LearnVector 不是另一个「苏格拉底导师」
严格说,到 2026 年 9 月初,LearnVector 还不能算一个已成形产品——它更像一家公司,加一套尚待验证的产品假设。按它公布的信息,它想做的不是一个回答问题的聊天机器人,也不是把现成课程换成 AI 教师重新讲一遍,而是一种长期陪伴学习者的一对一学习体验:
- 先了解你——你的工作、目标与现有基础;
- 为你规划路径——围绕目标组织学习过程;
- 随表现调整——节奏、案例与解释方式跟着你的反馈走;
- 以「掌握」为终点——不播完即止,陪到你真正能独立完成某件事。
举个例子:一位市场营销从业者想学数据分析。传统平台会推三门课《Python 基础》《数据分析入门》《商业统计学》,然后学习者要自己决定先学什么、哪章能跳、哪里该补、何时算学会。而 LearnVector 设想的学习路线可能是:先用营销报表讲数据结构,再用真实广告案例练数据清洗,遇到统计概念现场补知识,最后让他独立分析一份新业务数据来证明能力——学习过程不再由预先做好的课程决定,而是由学习者的目标与实时表现决定。
它首先瞄准的也是职业技能市场:帮白领适应 AI 带来的工作变化,潜在客户是企业、政府和高校;底层打算接多家公司的基础模型,不自己从头训一个大模型。所以更准确的说法是:LearnVector 更像一个建在大模型之上的「学习操作系统」。
二、Coursera 已经有 AI,为什么必须另起炉灶?
这是整件事最有意思的地方。
Coursera 的 Coach 已进入平台绝大多数课程、支持多种语言,能解释概念、生成练习、给反馈和职业建议;Course Builder 能帮机构生成课程;Dialogue 与 Role Play 把苏格拉底式对话和工作场景模拟放进在线学习。但吴恩达的判断是:拥有完善的 AI 学习功能,不等于拥有最好的 AI 原生学习体验。
区别在结构上:
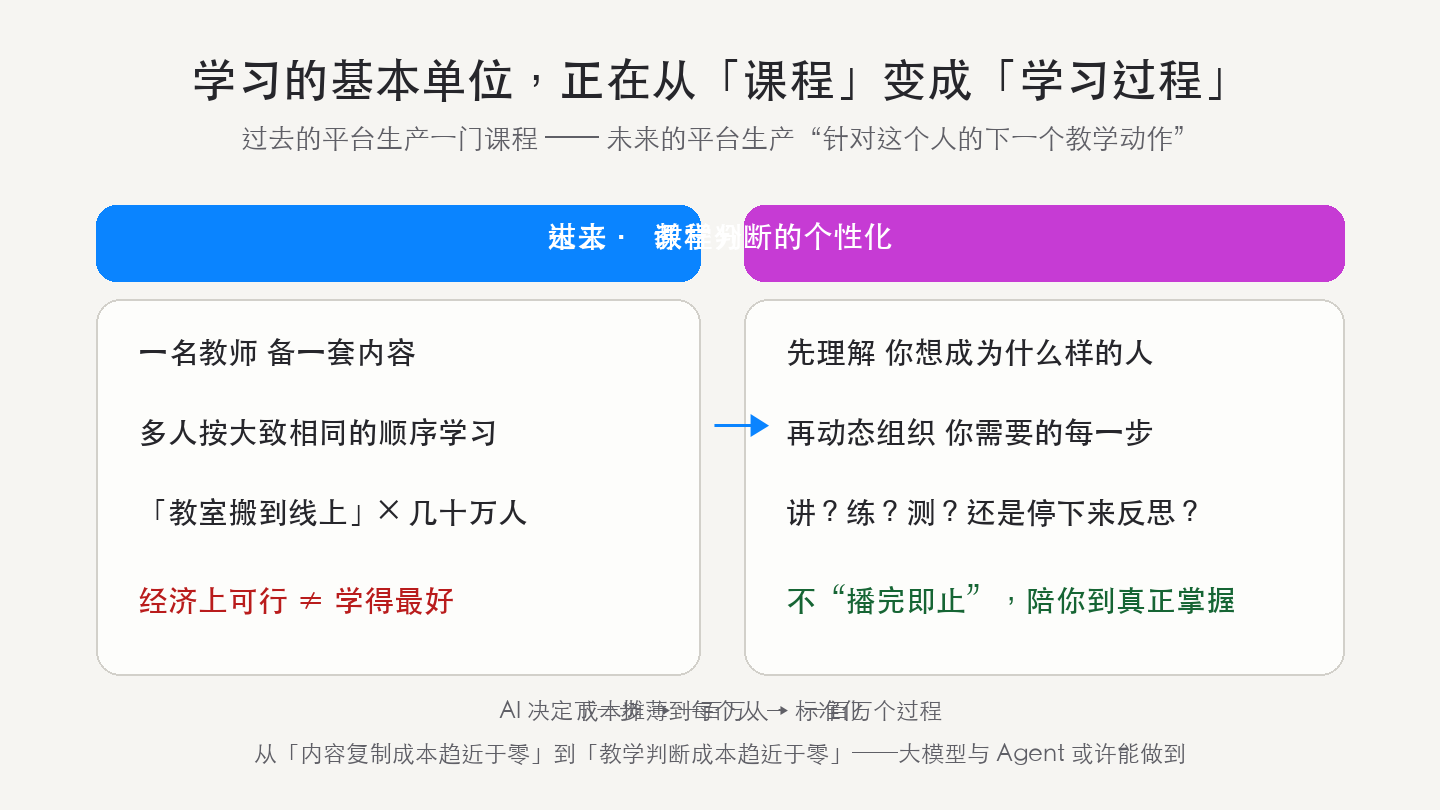
- Coursera 的基本结构:先有一门课(由大学、企业或教师预先生产)→ 学习者搜索注册 → 按固定章节顺序学 → 用测验作业证书证明完成。AI 在旁边解释、提问、翻译、反馈,但学习主路线仍由课程决定——这是「AI 辅助学习」,AI 像坐在教室后排的助教。
- LearnVector 想反过来:先理解学习者需要成为什么样的人,再动态组织他需要经历的学习过程——AI 试图成为整个教学过程的调度中心。它不只回答「这一段什么意思」,还要决定下一步该讲、该问、该练、该测,还是让他停下来反思。一条学习路径可能只取十门课里的二十个知识单元,再混入 AI 即时生成的案例与练习。学习者购买的将不再是「一门课程」,而是「掌握某项能力的过程」。
在这个分工里:Coursera 提供资金、可信内容、机构关系与分发渠道;LearnVector 不受旧产品结构约束,从零实验新形态——成了,技术可与 Coursera 共享;不成,也不必拆动 Coursera 整块业务。Coursera 自己把这笔投资描述为从「改善现有学习体验」走向「重新发明学习」。
一句话概括:Coursera 完成的是课程分发的工业化——同一门优质课服务一百万人;LearnVector 想用同一套后台,为一百万人分别生成不同的学习过程。
三、真正稀缺的不是「回答」,而是「克制」
听起来,这似乎只需一个够强的大模型加上长时记忆,就能当终身导师。但吴恩达团队真正焦虑的,恰恰是模型能不能忍住不立即回答。
两组研究正好说明这种张力:
- 一项针对高中数学学习的现场研究发现:没有教学护栏的生成式 AI 能帮学生在练习时表现更好,可一旦 AI 被拿走,学生独立解题的能力反而下降——AI 替学生承担了部分思考,形成认知卸载;加入教师设计的限制与提示策略后,伤害才缓解。
- 另一项 2025 年的大学物理实验则发现:经过专门设计的 AI 辅导系统确实能产生高于课堂主动学习的即时效果——但那个系统不是开放一个聊天框,而是控制教学顺序、限制模型行为、提供经过核验的材料。
把两者放一起,就看出了 LearnVector 的核心命题:一个好用的 AI 回答者,不一定是好的 AI 教师。
回答者追求快速解决问题;教师必须考虑学生以后能否独立解决。 回答者想减少用户阻力;教师有时反而要制造适度阻力。 回答者按满意度优化;教师关心保持、迁移与真实能力。
所以 AI 原生学习绝不是「聊天机器人 + 课程内容」。它至少还需要这些构件:
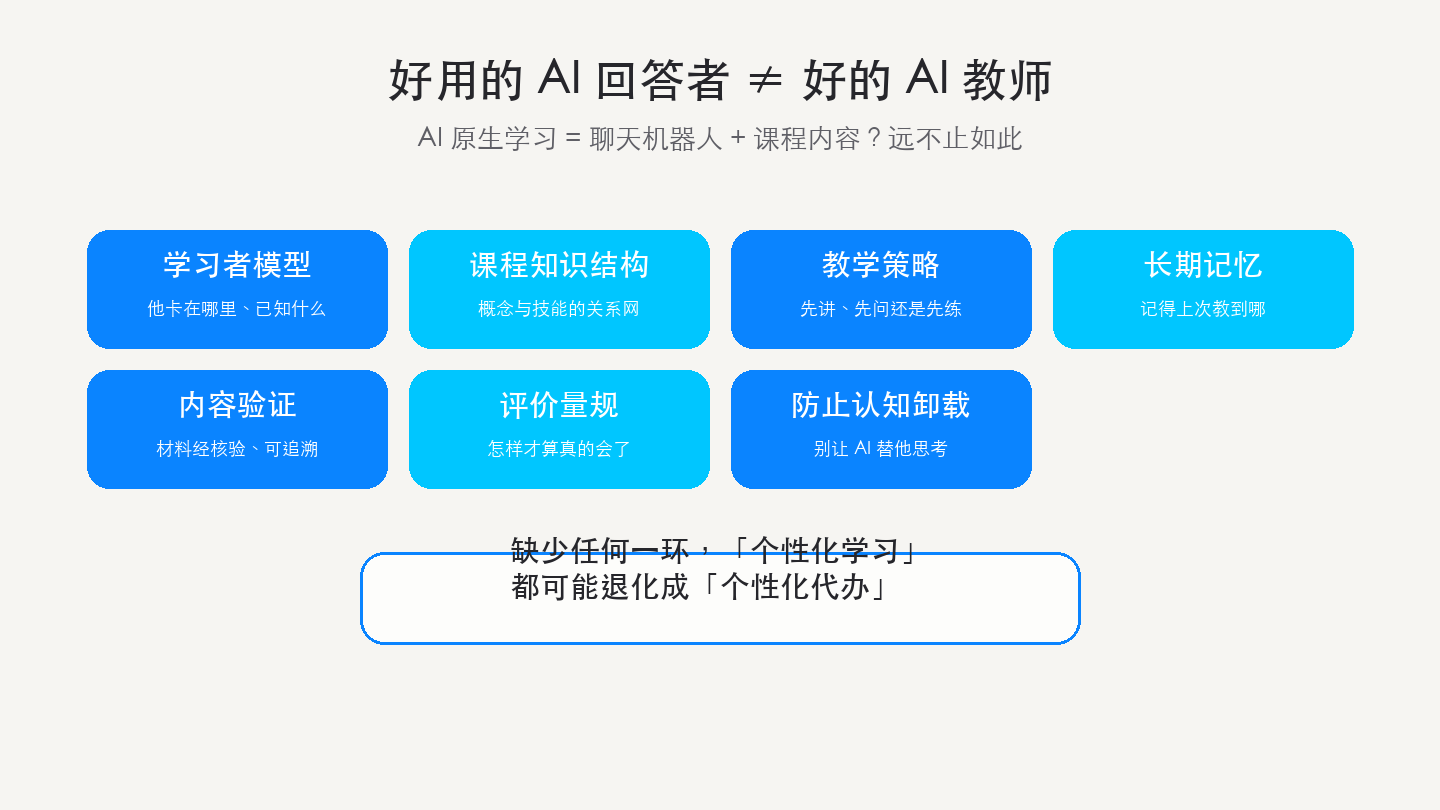
其中任何一环不到位,所谓「个性化学习」都可能变成「个性化代办」。
四、吴恩达的公开信:规模化教育是否必须依赖标准化?
要理解 LearnVector,最值得读的不是融资新闻,而是吴恩达在官网上亲自写的那封信。
十五年前,Coursera 帮他把斯坦福课堂的课程送到任何一个有互联网的人面前。但他后来说,自己只改变了「我们在哪里学习」,而这次他想改变的是「我们该怎样学习」——因为无论是大学课堂还是 MOOC,大多数学习仍建立在同一种生产方式上:一名教师备一套内容,很多人按大致相同的顺序学,只是教室从线下搬到线上、几十人变成几十万人。
吴恩达在信里给了一个很重的判断:
“Learning experiences have been optimized for economics rather than achievement.” ——过去的学习体验,很多时候不是按「怎样学得最好」设计的,而是按「怎样在经济上可行」设计的。
原因很简单:我们不可能给每个人都配一位优秀教师,于是发明了班级、统一进度、标准教材和预制课程,把教师有限的时间摊薄到更多人身上。Coursera 把这个逻辑推到极致——顶级课程的边际分发成本趋近于零。可问题是:如果几十万人各自卡在不同的地方,谁来分别作出几十万个不同的教学判断?
吴恩达说,好的学习远不只是给课程旁边放一个聊天机器人:
“Good learning needs much more than just a chatbot.”
过去的平台生产一门课程;未来的平台,生产的是「针对这个人、此时此刻的下一个教学动作」。他也因此反问:规模化教育,是否还必须依赖标准化?印刷术、广播电视、MOOC 降低的都是内容复制的成本,它们从未降低过「为每个学习者分别作出教学判断」的成本——而大模型与 Agent,或许能做到。
结语:对一线教师的三个提醒
这件事离我们并不远。把「LearnVector 想做的」翻译成课堂语言,其实是在问教师三件事:
- 你的「基本单位」是什么? 当我们说「教完这门课」,我们交付的是内容进度,还是能力达成?AI 时代,也许该把教学设计的基本单位从「课时/章节」换成「可验证的能力动作」。
- 你的「克制」在哪? AI 给了学生无限即时答案,教师的价值越来越多地体现在:什么环节允许 AI、什么环节必须独立思考、什么时候制造一点「必要难度」。
- 你要不要被「调度」? 如果 AI 原生学习真让系统来调度「下一步讲还是练」,教师的角色不会消失,但会从「内容生产者」转向「学习路径的设计者与最终裁判」——判断一个学习者的过程是否真的有效,仍是人的工作。
整理来源: 吴恩达官网公开信(Why I’m starting LearnVector)、LearnVector 官网介绍,以及 Coursera 投资公告与相关科技媒体报道(2026 年 7 月–9 月初)。
延伸想一想: 如果你手上有一门课,试着把其中一章重新设计成「按学习者实时表现调度」的形式——只保留 20% 的知识单元,其余换成 AI 生成的案例与练习,你会遇到哪些教师必须亲自守住的问题?